 APIMart Officially Launches seedance-2-5-flash APISeedance 2.5 Flash を見る: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APISeedance 2.5 Flash を見る: APIMart Officially Launches seedance-2-5-flash API
AI 音声付き動画生成:人物が話す動画を、セリフ・口の動き・環境音まで同時に生成します。あとからアフレコする必要はありません。下でモデルを切り替えて実際の結果を比べ、設定済みのパラメータでそのまま生成できます。
下のモデルはすべて同じプロンプトで生成しているので、セリフの聞き取りやすさ・口の動きの同期・環境音をそのまま比較できます。「このサンプルを使う」で上のツールにそのモデルの設定を読み込めます。
プロンプト
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
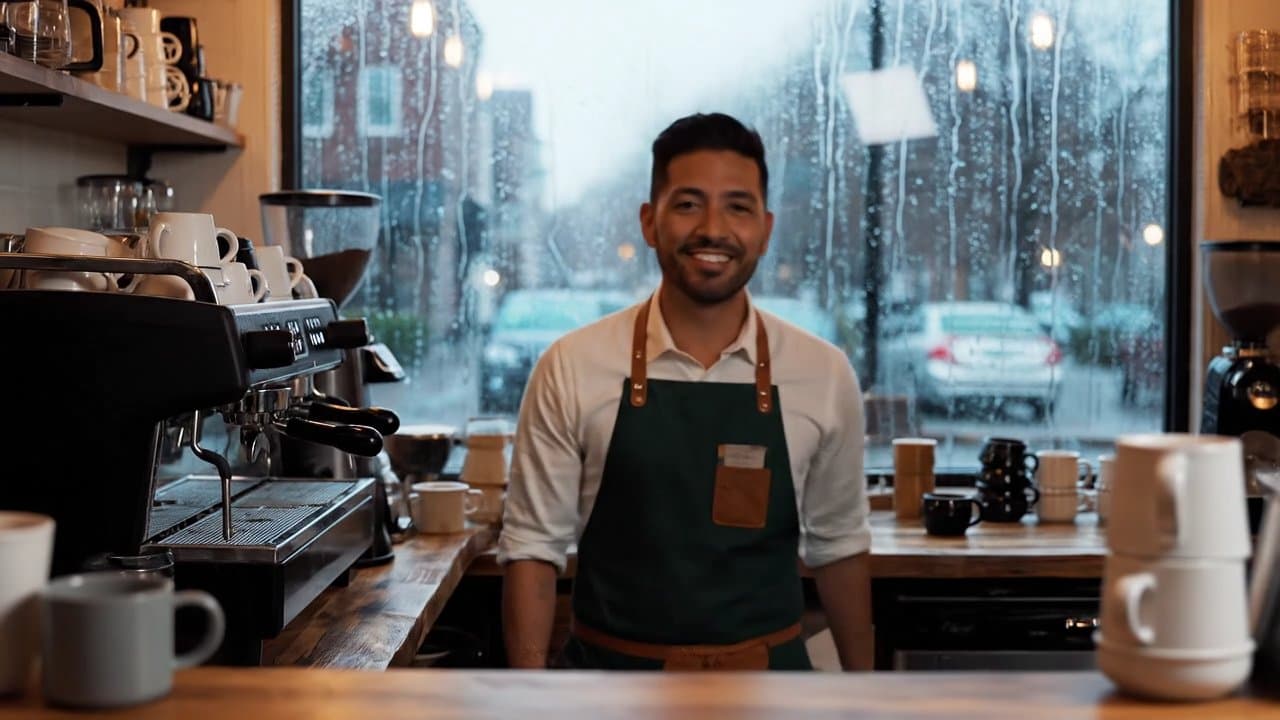
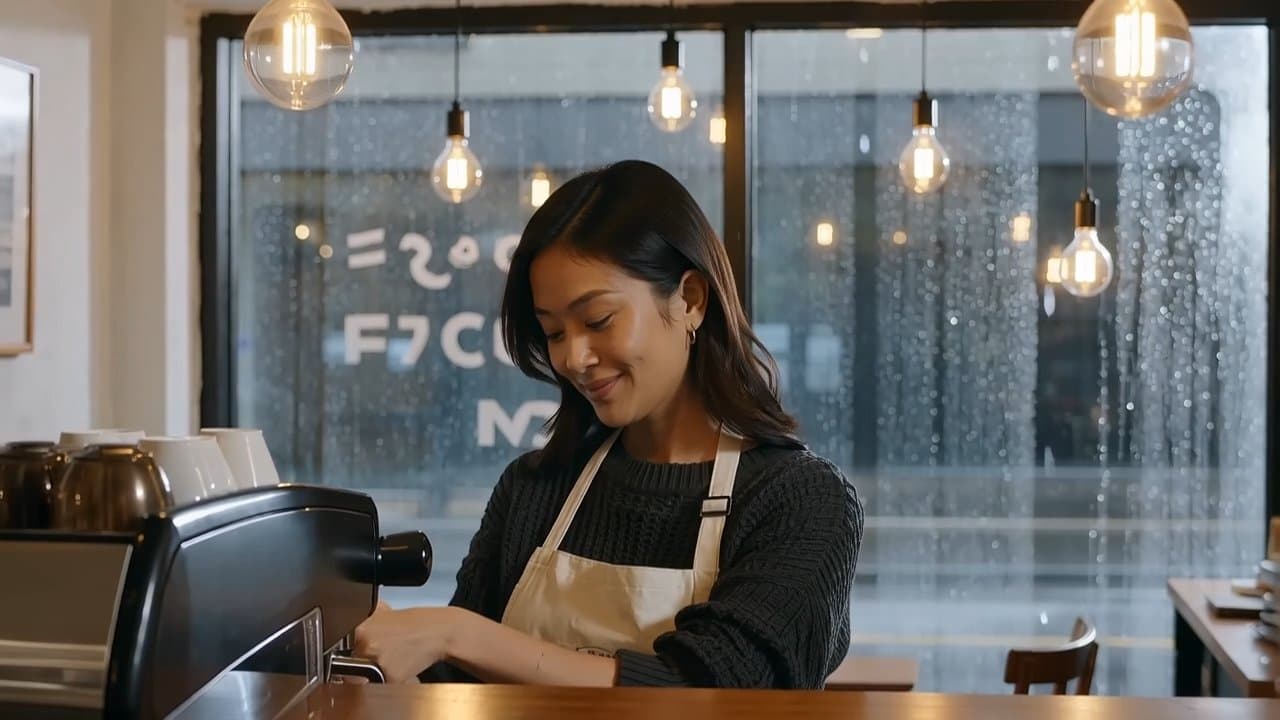
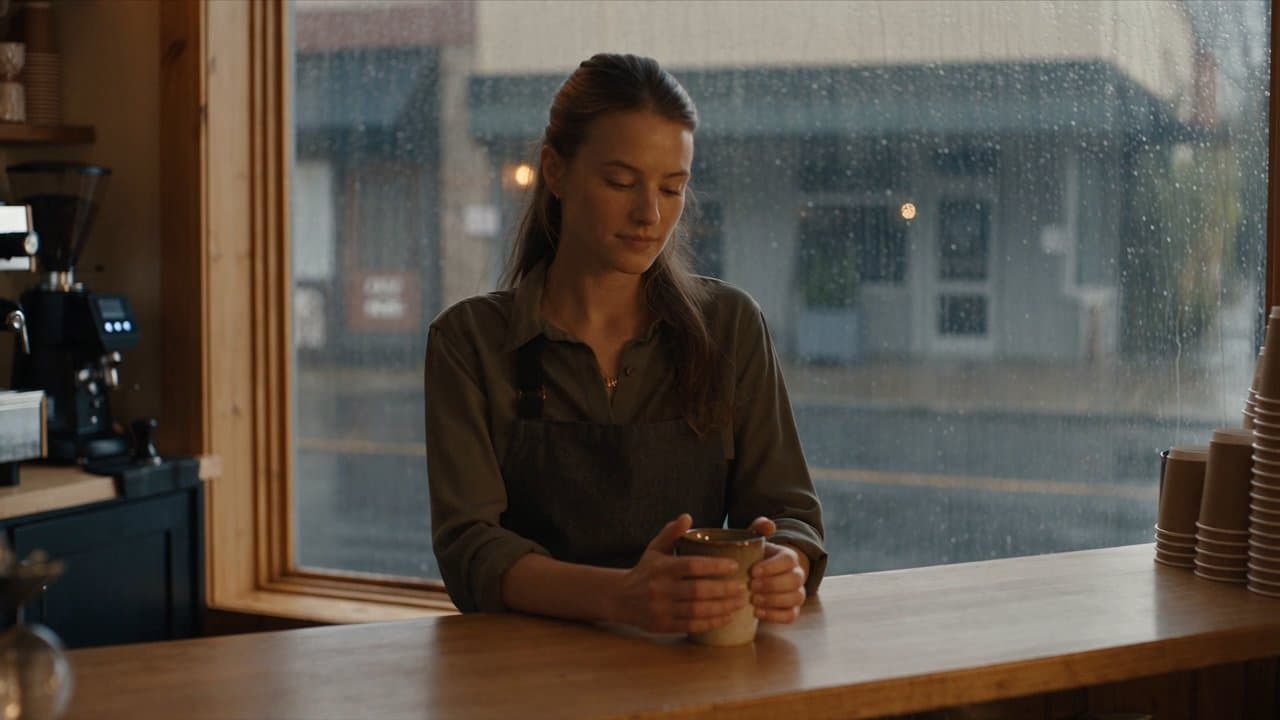
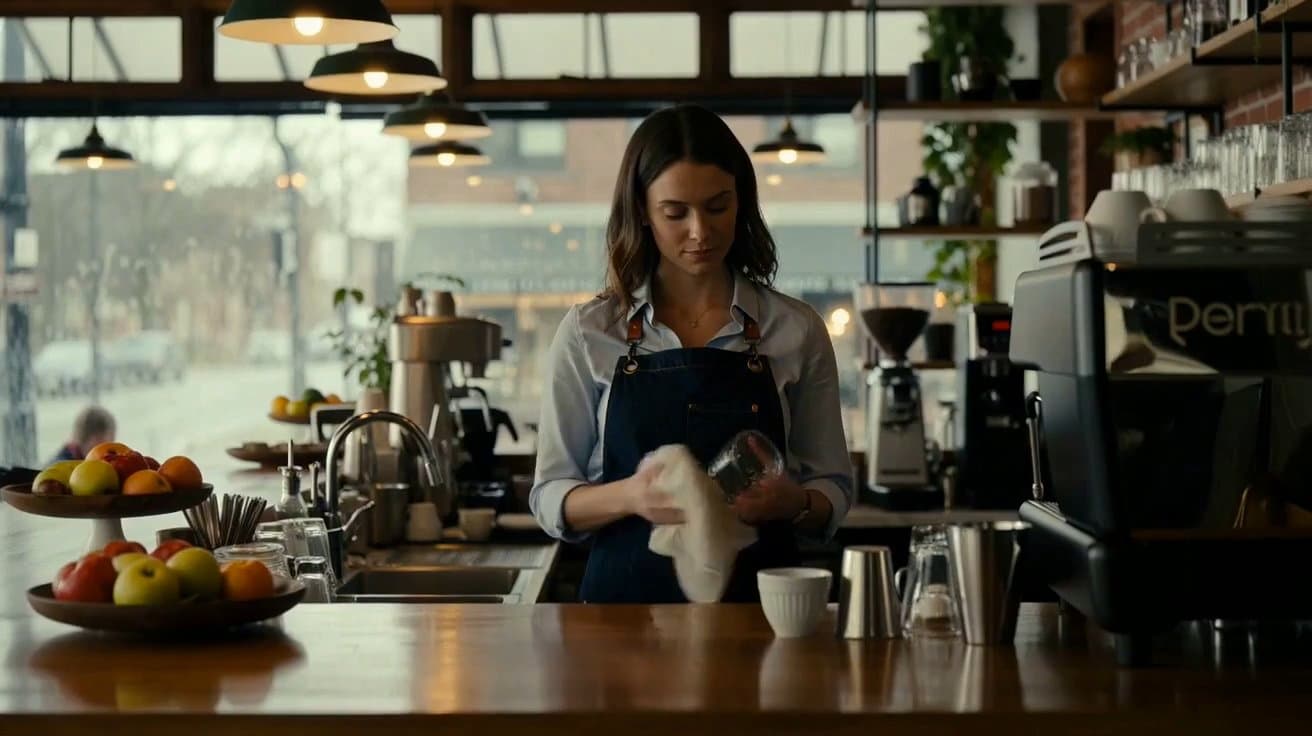
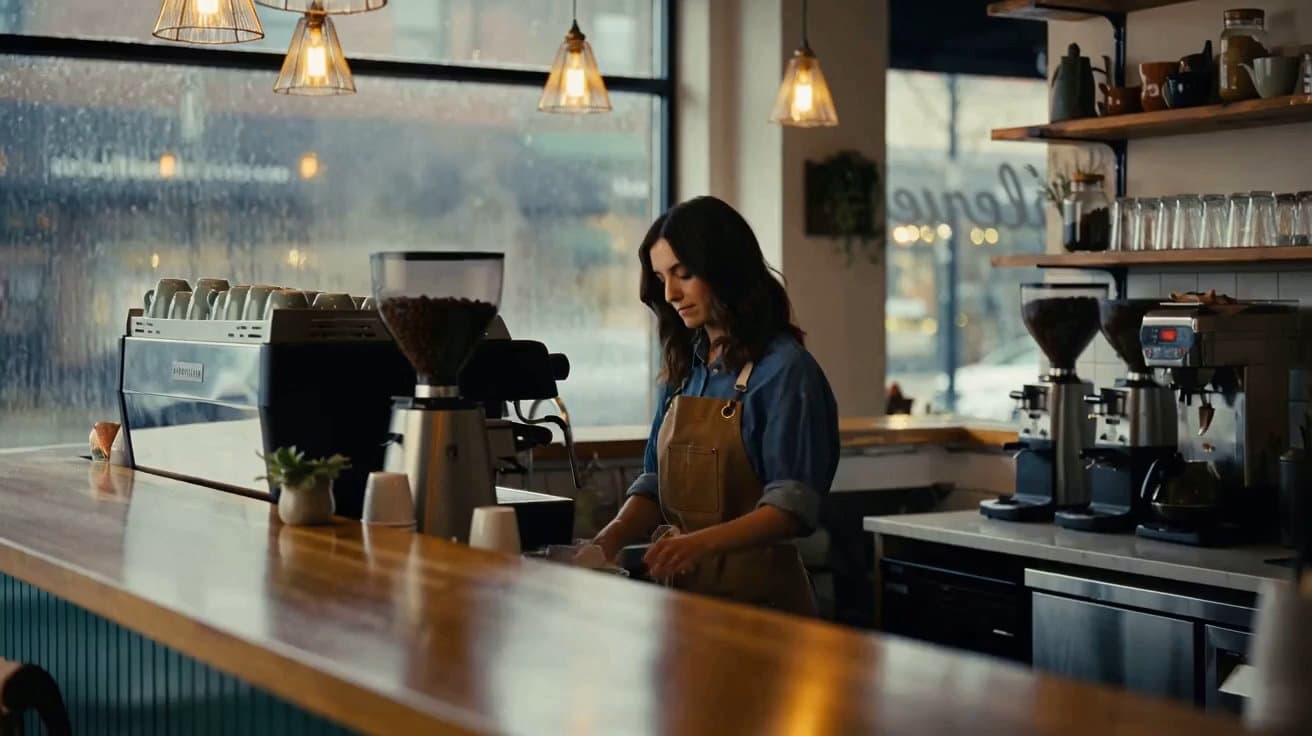
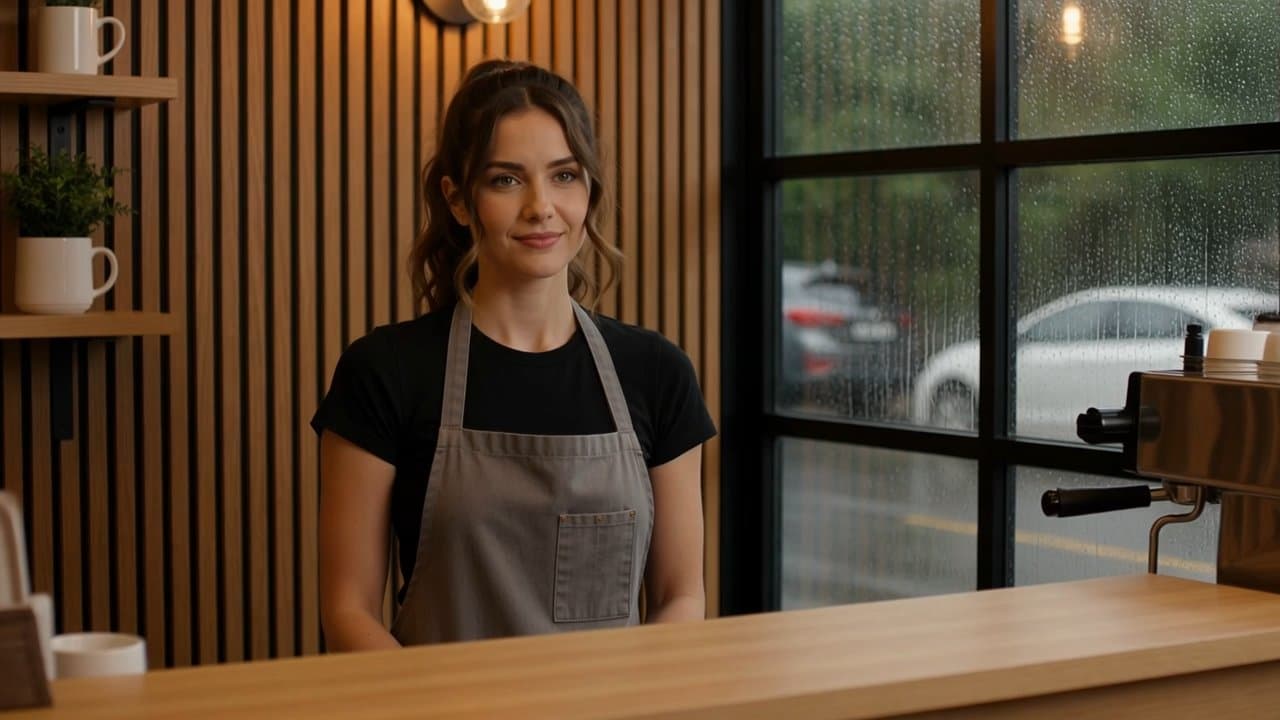
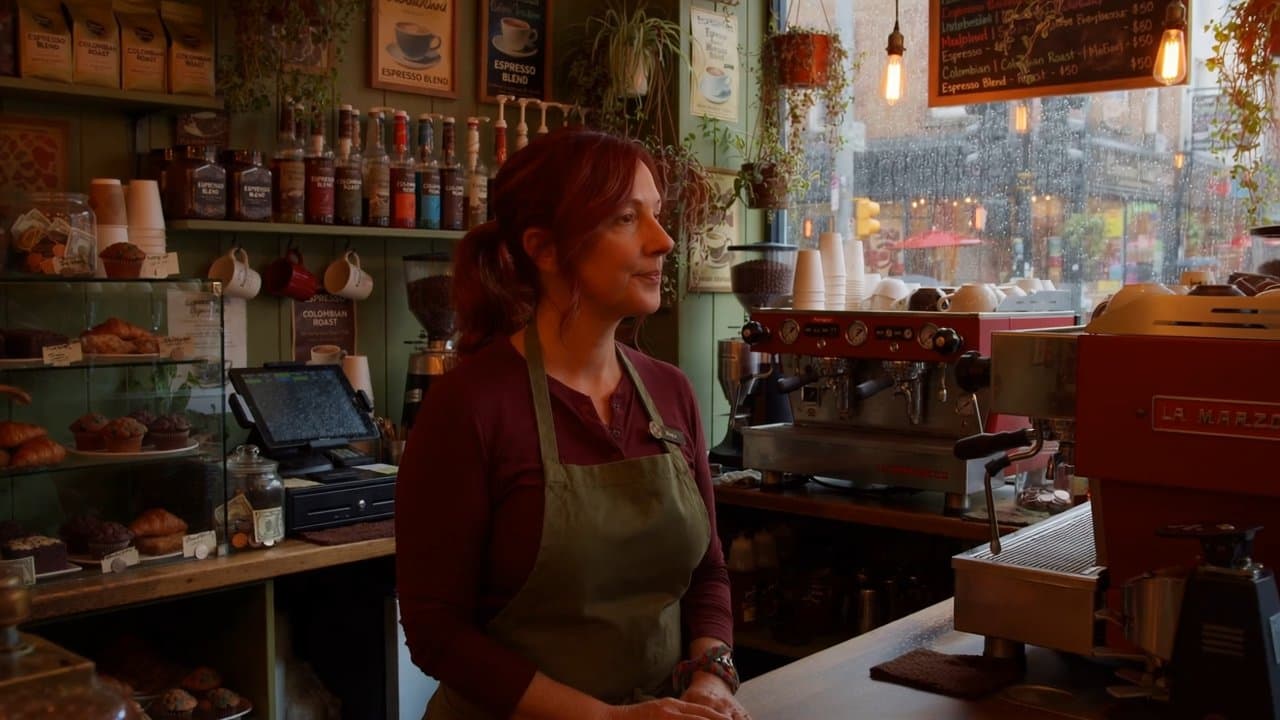
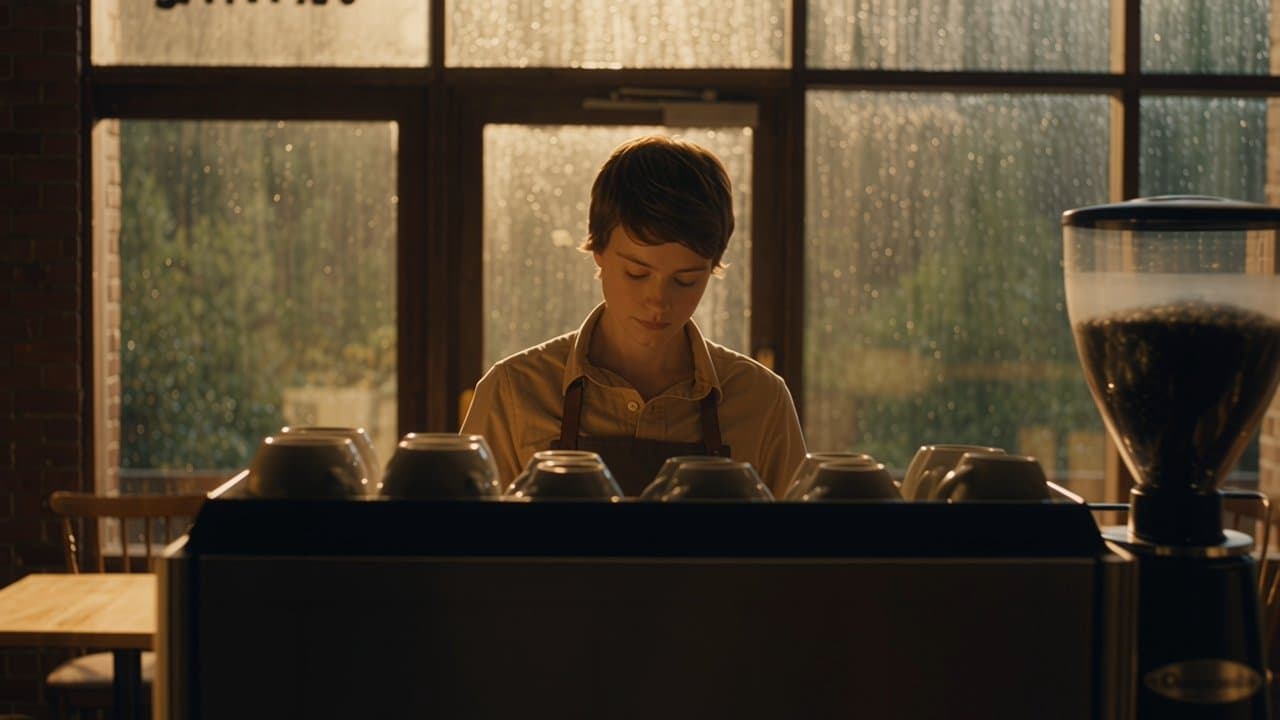
ネイティブ音声の動画は、映像と同時にセリフ・効果音・環境音を生成し、口の動きと声も同期します。アフレコが不要なので、広告のセリフ、ストーリー動画、SNS コンテンツに向いています。
この用途ではバリスタを例にしています。窓の外は雨で、バリスタが英語のセリフ「Welcome back.」をそっと口にします。プリセットは話し手 1 人・はっきりしたセリフ 1 行・自然な口の動き・室内の環境音を指定し、字幕は付けず、音楽で声をかき消さないよう指示しています。
この用途にはネイティブ音声に対応したモデルだけを掲載しており、音質と口の動きの同期にそれぞれ差があります。上でモデルを切り替えて比べ、最も自然なものを選んでください。
以下はすべて、この用途のプリセットを各モデルで実際に生成した結果です。上でそのモデルに切り替えればそのまま使えます。
| モデル | 得意なこと | 向いている用途 |
|---|---|---|
| Veo 3.1 Fast API | ネイティブ音声を映像と同時に生成、最初と最後のフレーム指定に対応 | 映像と音声がネイティブに同期したショート動画 |
| HappyHorse 1.0 API | デフォルトでネイティブ音声を生成、最初のフレームからの動画生成に対応 | ネイティブ音声付きのショート動画 |
| Seedance 2.5 API | 最長 30 秒、480p の試作から 1080p の本番へ切り替え可能 | 長回しと、試作から本番への切り替え |
| SkyReels V4 Fast API | 480p–1080p、3–15 秒、最初と最後のフレーム指定とマルチモーダル参照に対応 | すばやく作るマルチモーダルなショート動画 |
| SkyReels V4 Std API | 最初と最後のフレーム指定、複数の参照画像を使える Omni モードに対応 | 複数の参照画像を使う Omni モードでの制作 |
| Kling 4.0 API | 5 つのモード、720p / 1080p、3–30 秒、常にステレオ音声付き | 音声付きの長尺や複数素材を参照する短編 |
| Muse Video API | テキスト・参照画像から動画、約 10 秒・720p 固定で音声付き | 音声付きの 10 秒動画 |
| apimart-zoe API | 音声はオン・オフ・自動から選択、4–30 秒または自動、480p から 4K | 480p ドラフトから最大 4K まで仕上げるセリフ付き動画 |
上でモデルを切り替え、この用途での実際の結果・仕様・見込みクレジットを比べます。
シーンのプロンプトには話し手と音声の条件が設定済みです。その下に新しいセリフ・人物・場面を追加できます。
実行を押すと生成が始まり、結果は右側に表示されます。タスク履歴から呼び出して設定を再利用することもできます。
できます。シーンのプロンプトで音声の条件は固定されていますが、その下に新しいセリフと話し手を追加できます。セリフが短いほど、はっきり聞こえて同期もしやすくなります。
サンプルは英語のセリフです。一部のモデルは中国語の音声も生成できますが、仕上がりはモデルによって異なります。まず短い文で試してから一括生成することをおすすめします。
この用途ではネイティブで同期したセリフが必要なため、音声生成に対応したモデルだけを掲載しています。音声に対応していないモデルでは無音の動画になります。
違います。動画の多くは秒単位で課金され、仕様もモデルごとに異なります。実行ボタンに現在の設定での見込みクレジットが表示され、モデルを切り替えると自動で更新されます。
できます。各モデルは Web ツールと同じパラメータの API を提供しています。モデルページでリクエストパラメータとドキュメントを確認でき、音声付き動画をまとめて生成できます。
ページ右下のライブチャット、[email protected] へのメール、またはDiscordコミュニティからお問い合わせいただけます。チームができるだけ早くご対応いたします。