 APIMart Officially Launches seedance-2-5-flash APIExplorar Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APIExplorar Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash API
Gerador de vídeo com áudio por IA: crie clipes em que um personagem fala, com diálogo, movimento labial e som ambiente gerados juntos, sem precisar de dublagem na pós-produção. Troque de modelo abaixo, compare resultados reais e gere com as configurações prontas.
Todos os modelos abaixo usam o mesmo prompt, para você comparar clareza da fala, sincronia labial e som ambiente diretamente. Clique em Usar este exemplo para carregar as configurações do modelo na ferramenta acima.
Prompt
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
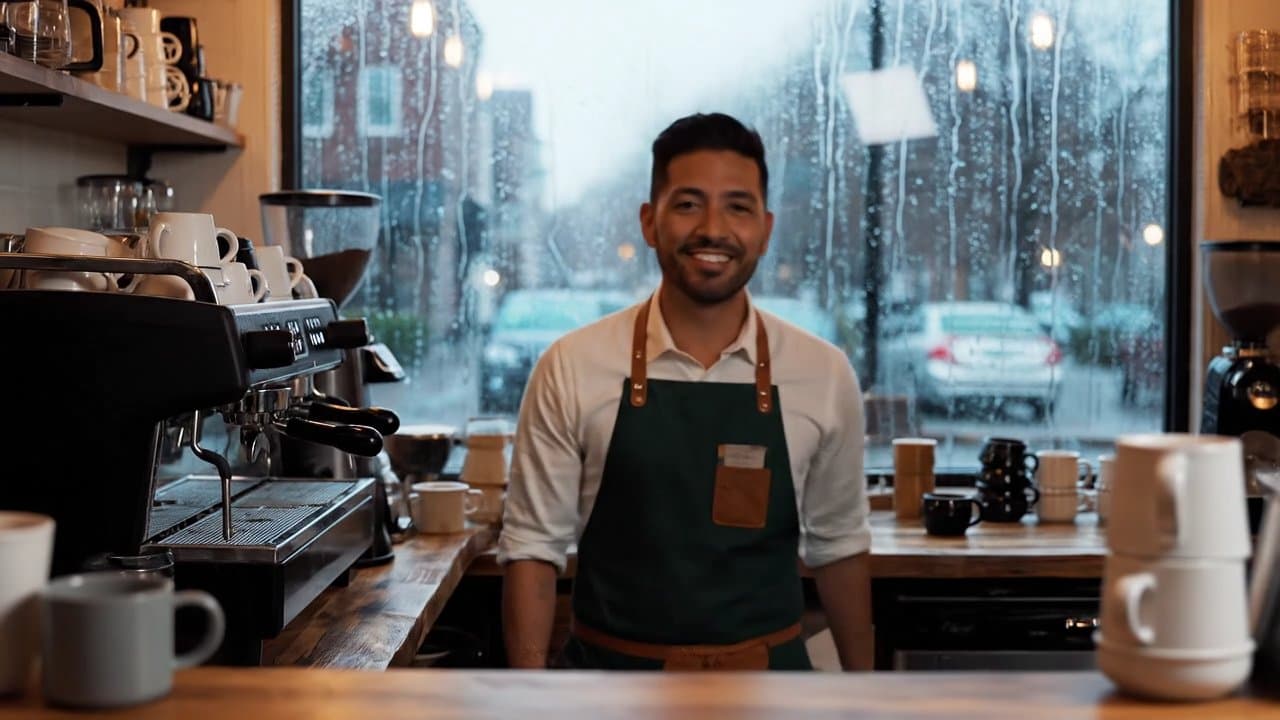
Texto para vídeo · 16:9 · 720p · 8s
Veo 3.1 Fast APIUsar este exemplo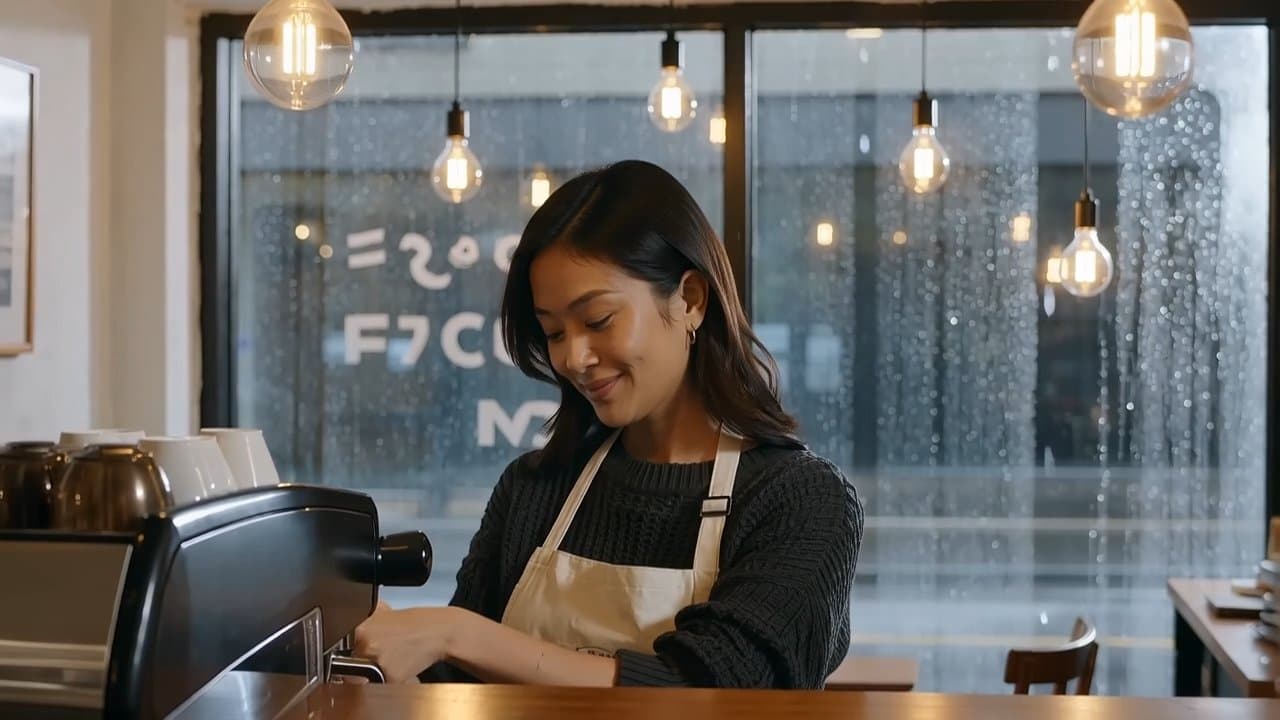
Texto para vídeo · 16:9 · 720P · 7s
HappyHorse 1.0 APIUsar este exemplo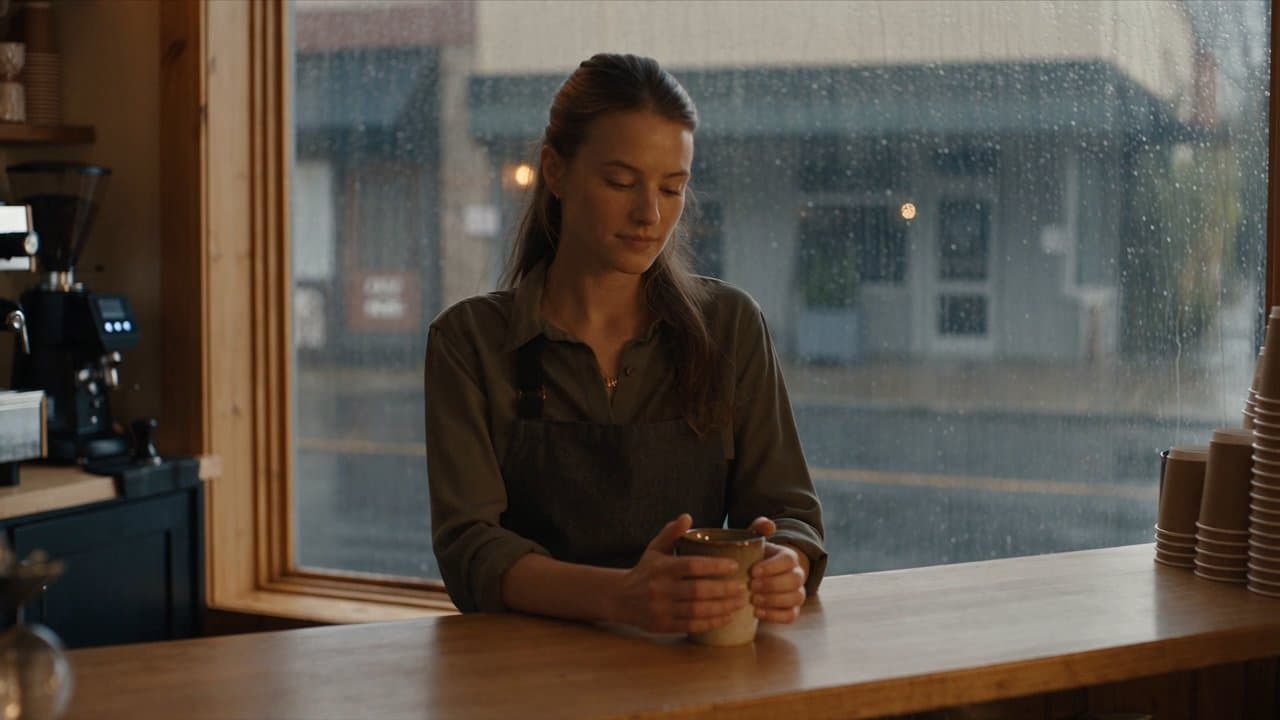
Texto para vídeo · 16:9 · 720p · 7s
Seedance 2.5 APIUsar este exemplo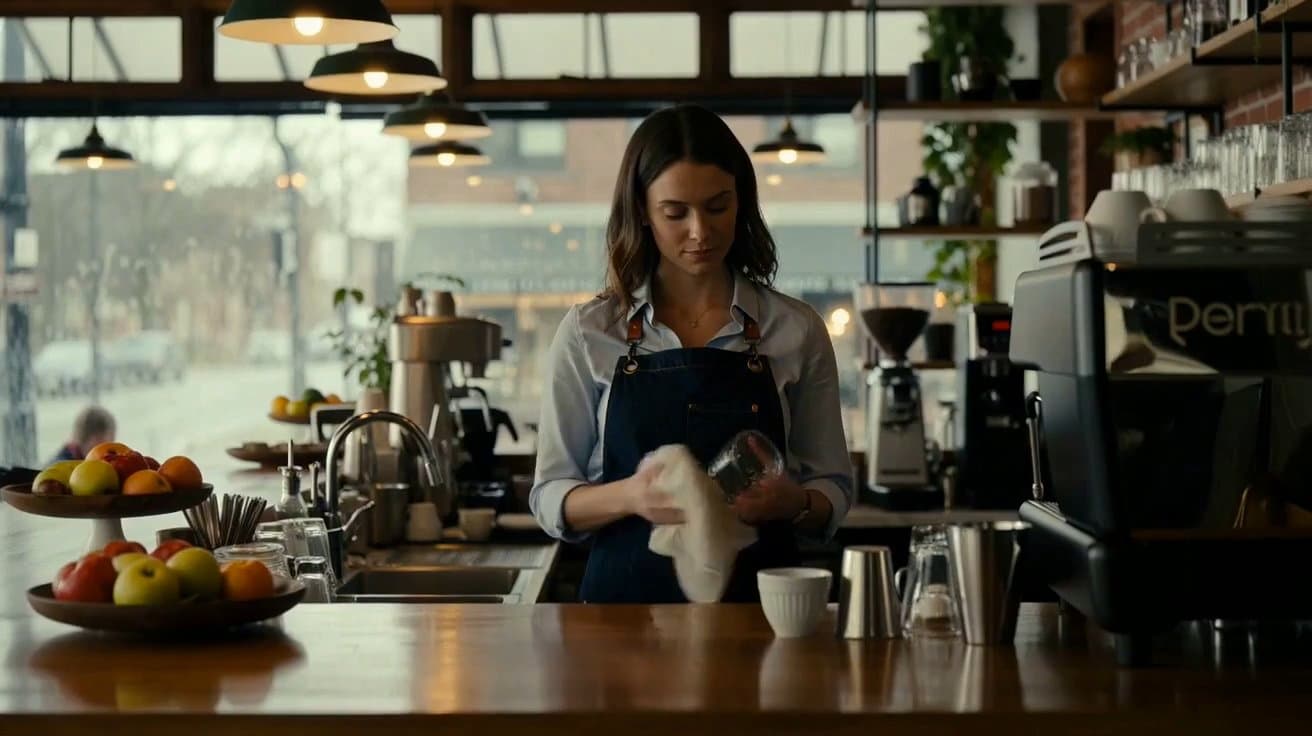
Texto para vídeo · 16:9 · 720p · 7s
SkyReels V4 Fast APIUsar este exemplo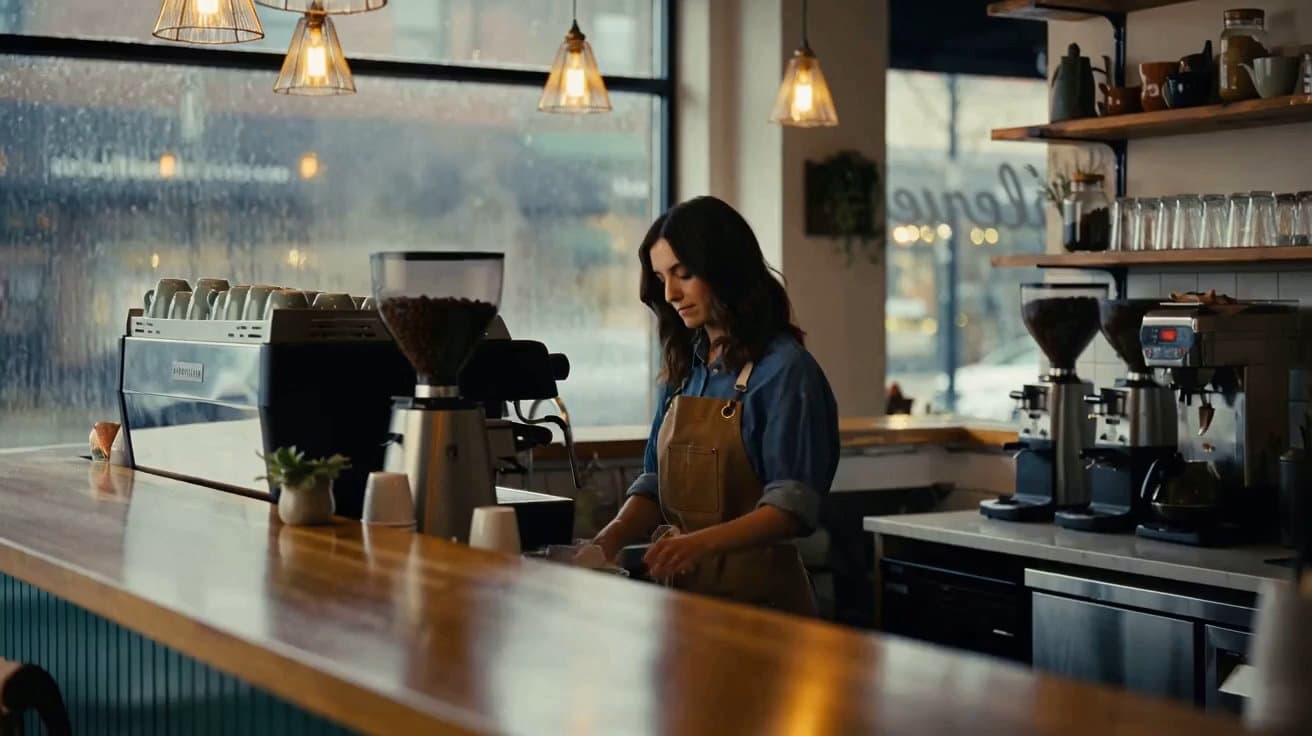
Texto para vídeo · 16:9 · 720p · 7s
SkyReels V4 Std APIUsar este exemplo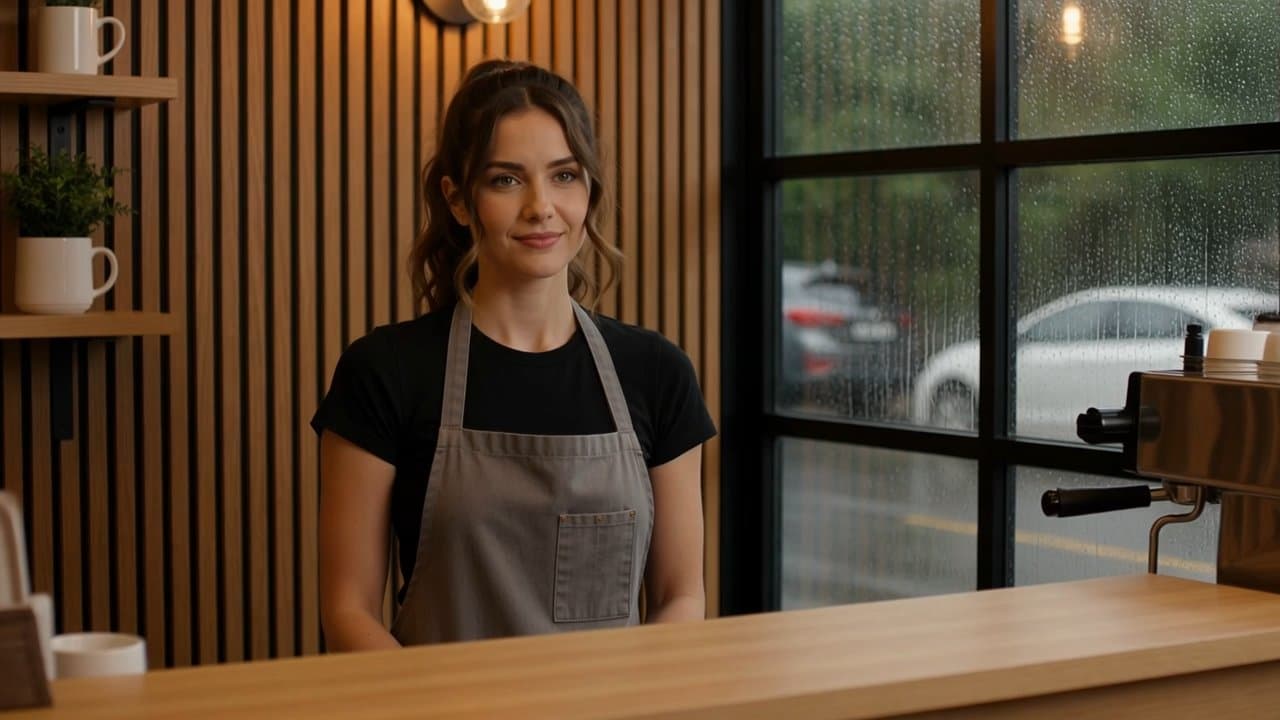
Texto para vídeo · 16:9 · 720p · 5s
Kling 4.0 APIUsar este exemplo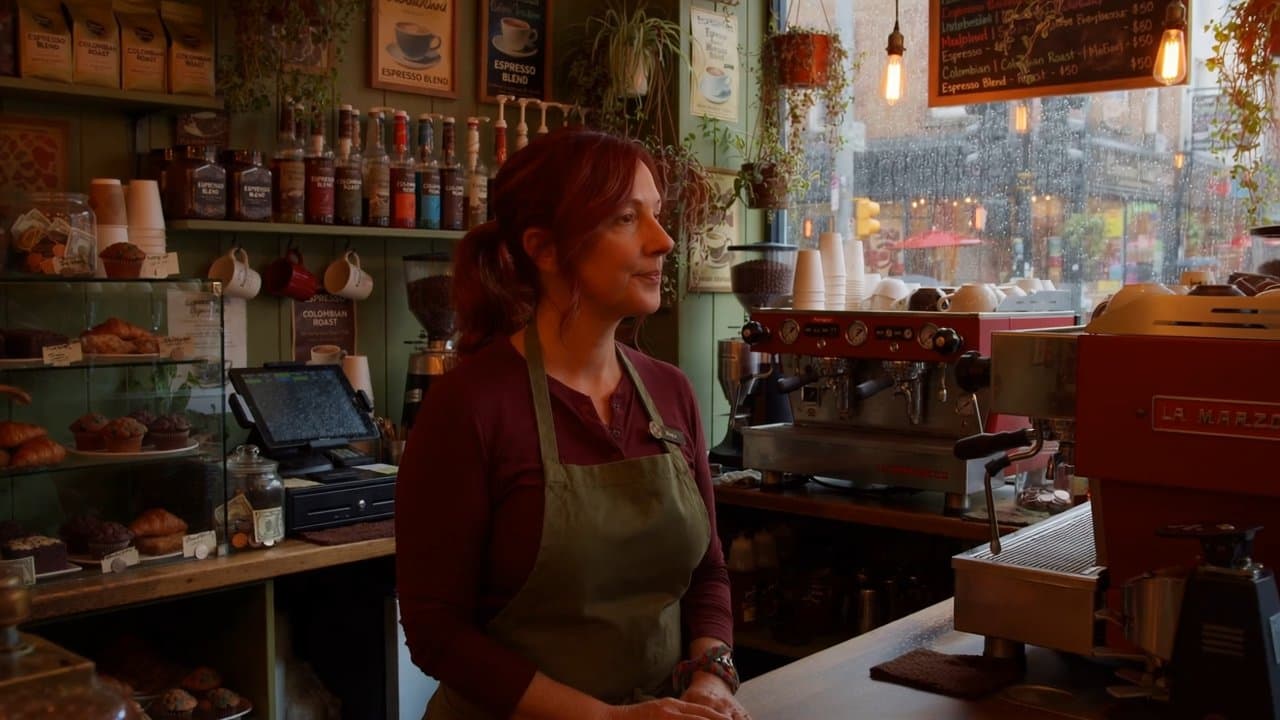
Texto para vídeo · 16:9 · 720p · 10s
Muse Video APIUsar este exemplo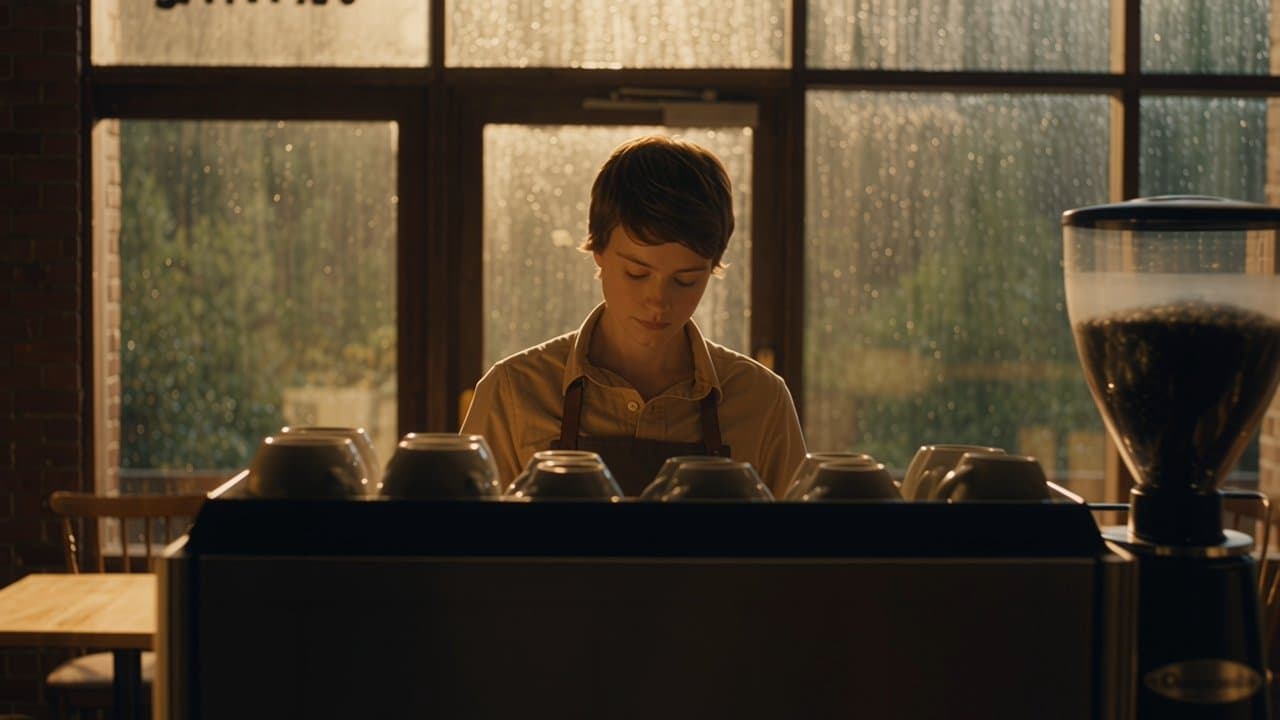
Texto para vídeo · 16:9 · 720p · 5s
apimart-zoe APIUsar este exemploO vídeo com áudio nativo gera diálogo, efeitos sonoros e som ambiente junto com a imagem, com os lábios sincronizados, sem precisar de dublagem separada. Funciona bem para diálogos de anúncios, histórias curtas e conteúdo para redes sociais.
Este caso de uso mostra alguém atrás do balcão de uma cafeteria que diz baixinho “Welcome back.” enquanto a chuva bate na janela. A configuração pede uma única pessoa falando e uma única fala clara, movimento labial crível e som ambiente interno, sem legendas e sem música encobrindo a voz.
Aqui entram só modelos com áudio nativo, e eles variam na qualidade do som e na sincronia labial. Troque de modelo acima para comparar e escolha o mais natural.
Cada exemplo é um resultado real do prompt deste caso de uso naquele modelo. Mude para o modelo acima para usá-lo diretamente.
| Modelo | Pontos fortes | Ideal para |
|---|---|---|
| Veo 3.1 Fast API | Áudio nativo gerado em sincronia com a imagem, primeiro e último quadro | Clipes com áudio nativo sincronizado |
| HappyHorse 1.0 API | Áudio nativo por padrão, imagem para vídeo a partir do primeiro quadro | Clipes com áudio nativo |
| Seedance 2.5 API | Até 30 segundos, prévia em 480p e versão final em 1080p | Planos longos, da prévia à versão final |
| SkyReels V4 Fast API | 480p–1080p, 3–15 segundos, primeiro e último quadro e referências multimodais | Clipes multimodais rápidos |
| SkyReels V4 Std API | Primeiro e último quadro e modo Omni com várias referências | Criação Omni com várias imagens de referência |
| Kling 4.0 API | Cinco modos, 720p / 1080p, 3–30 segundos, sempre com áudio estéreo | Clipes longos com som e várias referências |
| Muse Video API | Texto e imagem de referência para vídeo, fixo em cerca de 10 segundos e 720p, com som | Clipes de 10 segundos com som |
| apimart-zoe API | Áudio ligado, desligado ou automático, 4–30 segundos ou automática, de 480p a 4K | Clipes com diálogo até 4K, com rascunho em 480p antes |
Troque de modelo acima para comparar resultados reais, especificações e créditos estimados neste caso de uso.
O prompt do caso de uso já define quem fala e os requisitos de áudio. Adicione abaixo dele uma nova fala, um personagem e um cenário.
Clique em Executar para gerar. Os resultados aparecem à direita e podem ser encontrados no histórico para reutilizar as configurações.
Sim. O prompt do caso de uso bloqueia os requisitos de áudio, mas você pode adicionar abaixo dele uma nova fala e quem a diz. Falas mais curtas saem mais claras e mais bem sincronizadas.
O exemplo usa inglês. Alguns modelos conseguem gerar fala em chinês, com resultados variados, então teste uma frase curta antes de gerar em lote.
Este caso de uso exige diálogo sincronizado nativo, então só entram modelos que geram áudio. Modelos sem áudio geram vídeo sem som.
Não. A maioria dos vídeos é cobrada por segundo, e cada modelo tem suas próprias especificações. O botão Executar mostra os créditos estimados para as configurações atuais e é atualizado quando você troca de modelo.
Sim. Cada modelo oferece uma API com os mesmos parâmetros da ferramenta web. Na página do modelo você encontra os parâmetros de requisição e a documentação para gerar vídeos com áudio em lote.
Você pode nos contatar pelo chat ao vivo no canto inferior direito da página, enviar um e-mail para [email protected] ou entrar na nossa comunidade do Discord. Nossa equipe responderá o mais rápido possível.