 APIMart Officially Launches seedance-2-5-flash APIDécouvrir Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APIDécouvrir Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash API
Générateur de vidéo IA avec son : créez des clips où un personnage parle, avec dialogues, mouvements des lèvres et son d’ambiance générés ensemble, sans doublage en post-production. Changez de modèle ci-dessous, comparez de vrais résultats puis générez avec les réglages prêts.
Tous les modèles ci-dessous utilisent le même prompt, pour comparer directement la clarté de la voix, la synchro labiale et le son d’ambiance. Cliquez sur « Utiliser cet exemple » pour charger les réglages du modèle dans l’outil ci-dessus.
Prompt
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
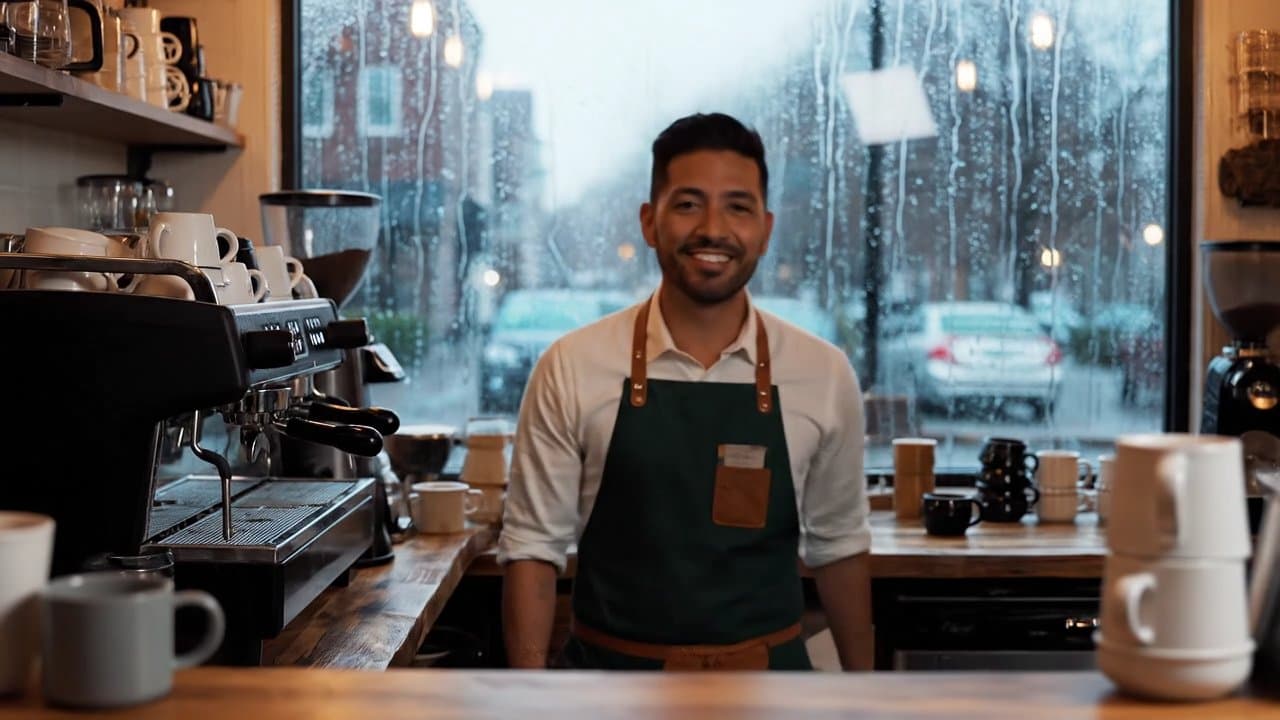
Texte vers vidéo · 16:9 · 720p · 8s
Veo 3.1 Fast APIUtiliser cet exemple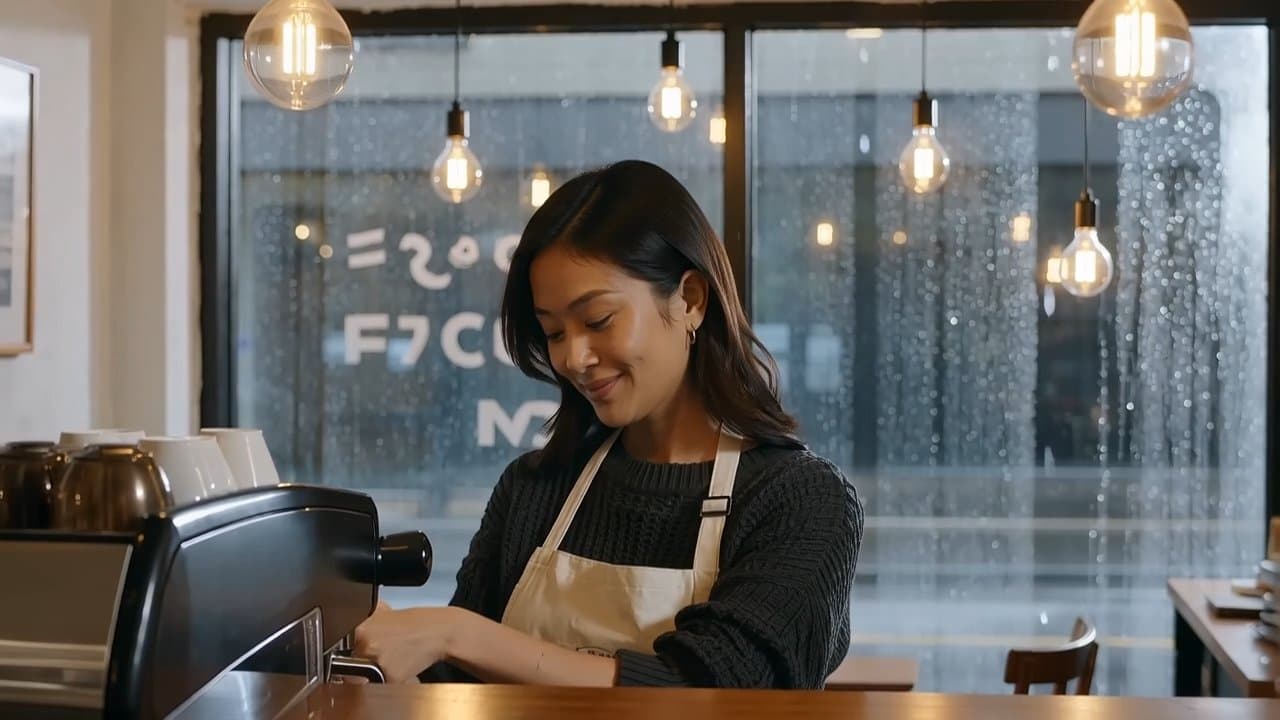
Texte vers vidéo · 16:9 · 720P · 7s
HappyHorse 1.0 APIUtiliser cet exemple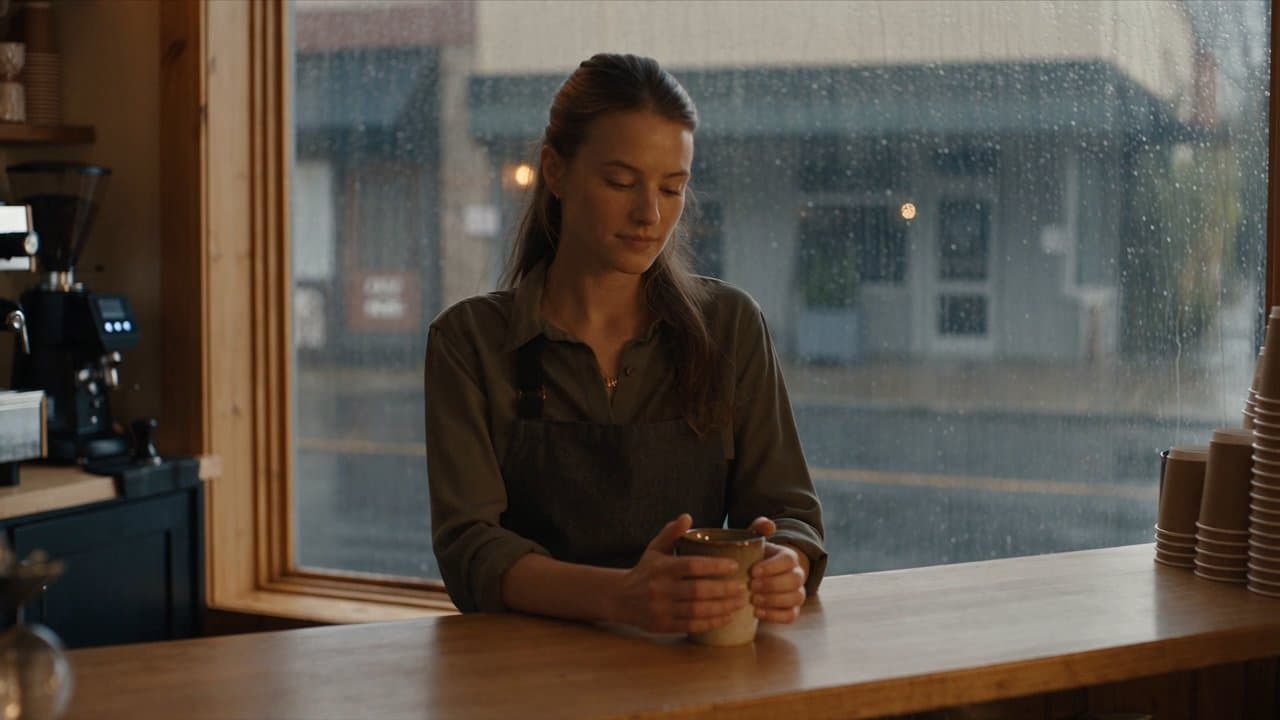
Texte vers vidéo · 16:9 · 720p · 7s
Seedance 2.5 APIUtiliser cet exemple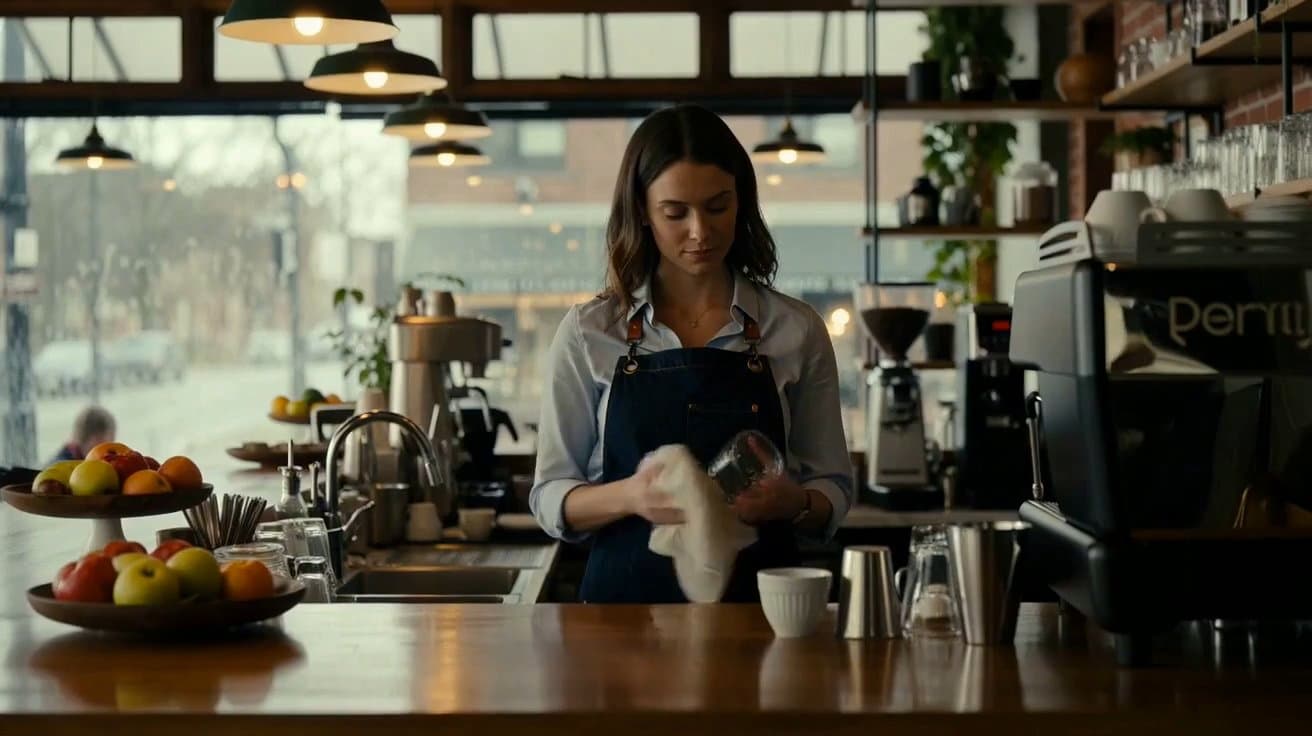
Texte vers vidéo · 16:9 · 720p · 7s
SkyReels V4 Fast APIUtiliser cet exemple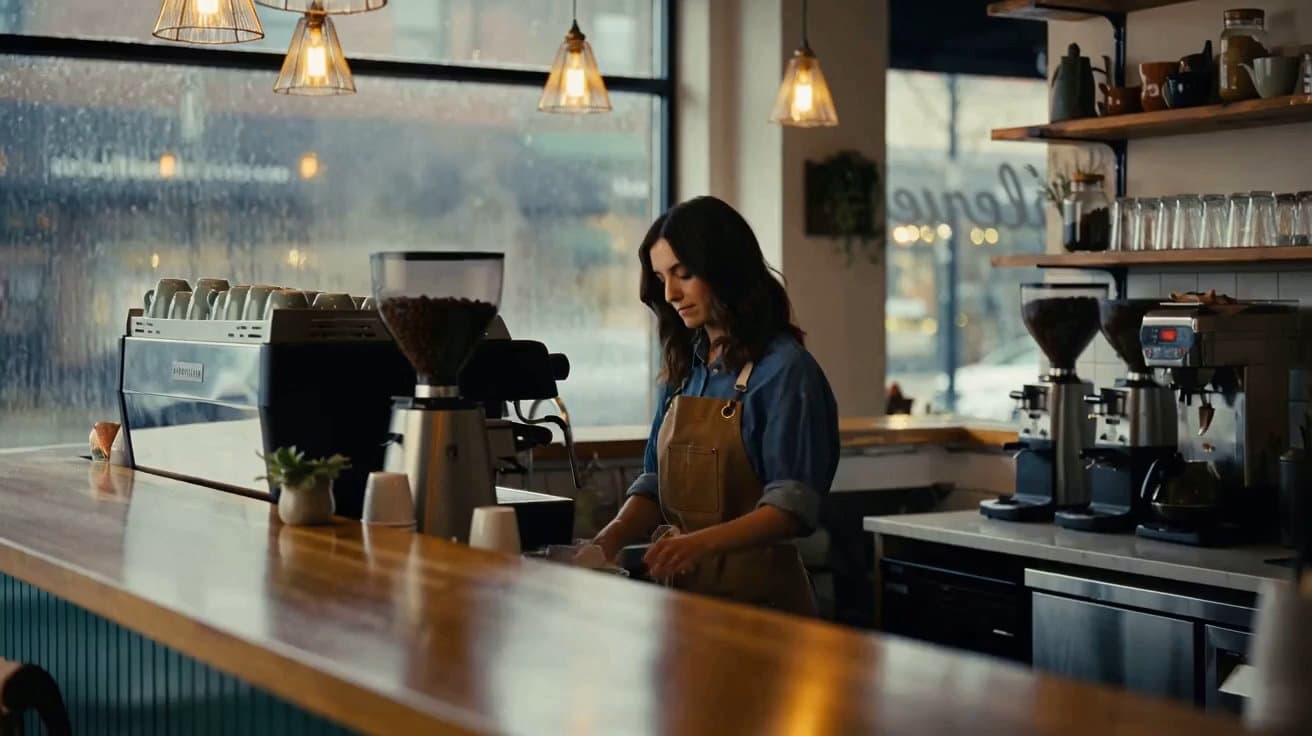
Texte vers vidéo · 16:9 · 720p · 7s
SkyReels V4 Std APIUtiliser cet exemple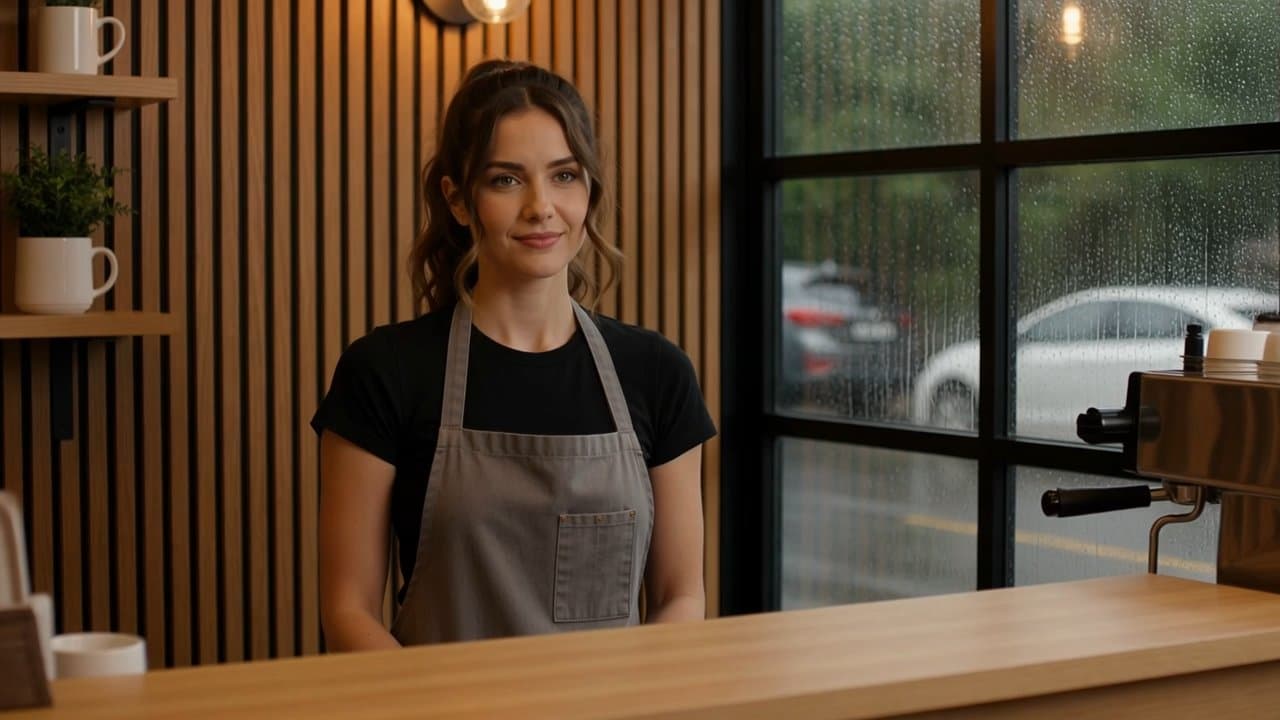
Texte vers vidéo · 16:9 · 720p · 5s
Kling 4.0 APIUtiliser cet exemple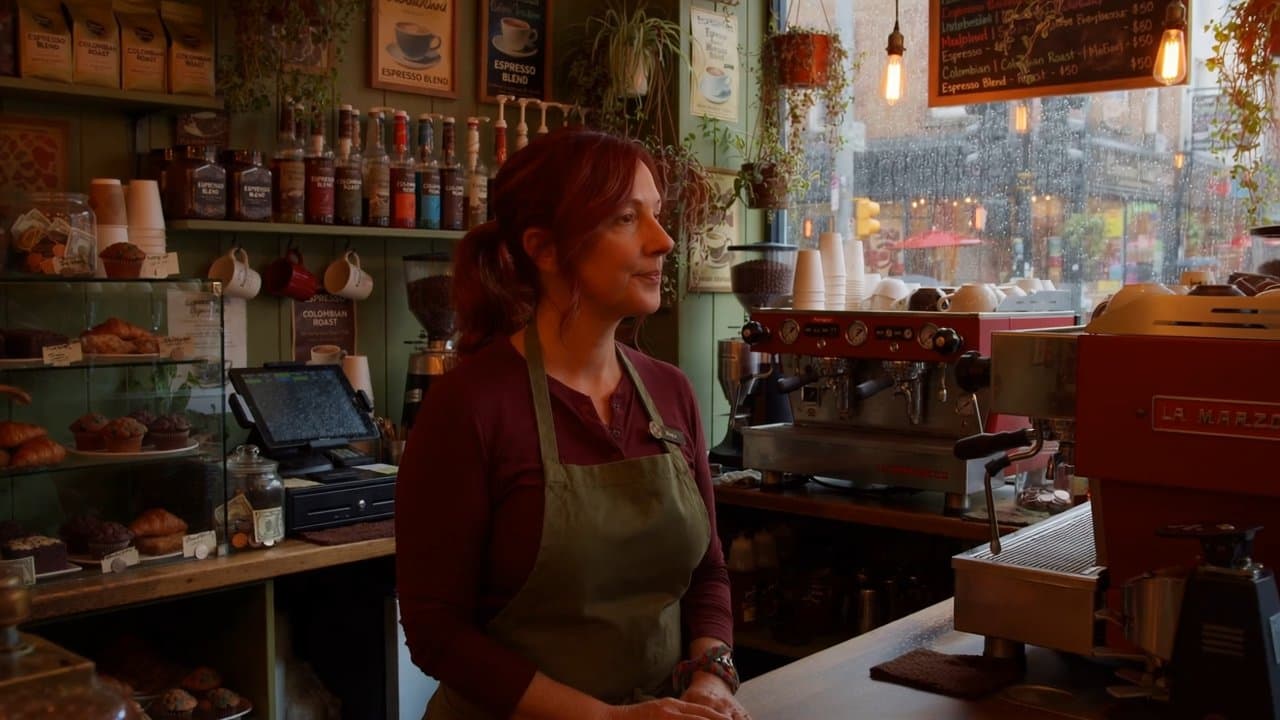
Texte vers vidéo · 16:9 · 720p · 10s
Muse Video APIUtiliser cet exemple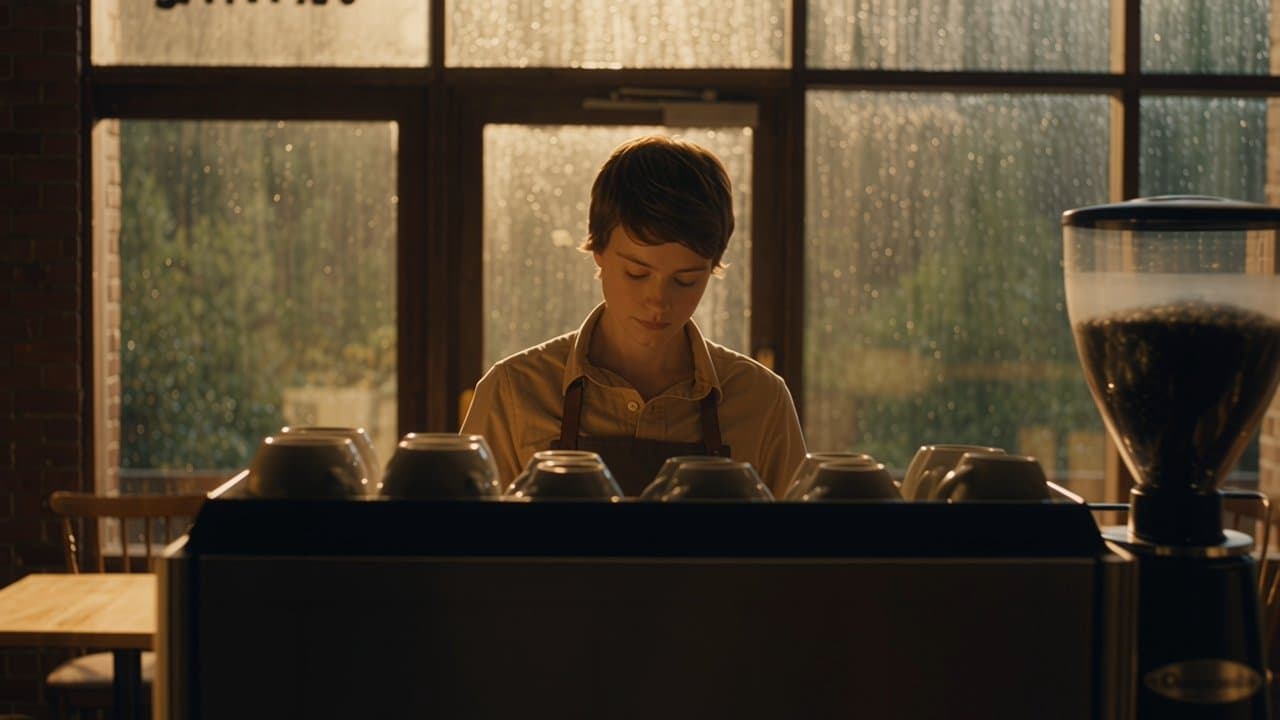
Texte vers vidéo · 16:9 · 720p · 5s
apimart-zoe APIUtiliser cet exempleLa vidéo à audio natif génère dialogues, effets sonores et ambiance en même temps que l’image, avec des lèvres synchronisées, sans doublage séparé. Elle convient aux dialogues publicitaires, aux courts récits et aux contenus pour les réseaux sociaux.
Ce cas d’usage met en scène une personne derrière le comptoir d’un café qui dit doucement « Welcome back. » pendant que la pluie tape contre la vitre. Le réglage demande un seul personnage qui parle et une seule réplique claire, des mouvements de lèvres crédibles et une ambiance intérieure, sans sous-titres ni musique couvrant la voix.
Seuls les modèles à audio natif figurent ici, et ils diffèrent par la qualité du son et la synchro labiale. Changez de modèle ci-dessus pour comparer, puis choisissez le plus naturel.
Chaque exemple est un résultat réel du prompt de ce cas d’usage sur ce modèle. Passez à ce modèle ci-dessus pour l’utiliser directement.
| Modèle | Points forts | Idéal pour |
|---|---|---|
| Veo 3.1 Fast API | Audio natif généré en synchro avec l’image, première et dernière image | Clips avec audio natif synchronisé |
| HappyHorse 1.0 API | Audio natif par défaut, image vers vidéo depuis la première image | Clips avec audio natif |
| Seedance 2.5 API | Jusqu’à 30 secondes, brouillon en 480p puis version finale en 1080p | Plans longs, du brouillon à la version finale |
| SkyReels V4 Fast API | 480p–1080p, 3–15 secondes, première et dernière image, références multimodales | Clips multimodaux rapides |
| SkyReels V4 Std API | Première et dernière image, mode Omni avec plusieurs références | Création Omni avec plusieurs images de référence |
| Kling 4.0 API | Cinq modes, 720p / 1080p, 3–30 secondes, toujours avec son stéréo | Clips longs avec son et plusieurs références |
| Muse Video API | Texte et image de référence en vidéo, fixé à environ 10 secondes en 720p, avec son | Clips de 10 secondes avec son |
| apimart-zoe API | Son activé, désactivé ou automatique, 4–30 secondes ou automatique, de 480p à 4K | Clips dialogués jusqu’en 4K, avec un brouillon 480p d’abord |
Changez de modèle ci-dessus pour comparer résultats réels, spécifications et crédits estimés pour ce cas d’usage.
Le prompt du cas d’usage fixe déjà le personnage qui parle et les exigences audio. Ajoutez en dessous une nouvelle réplique, un personnage et un décor.
Cliquez sur Exécuter. Les résultats s’affichent à droite et restent accessibles dans l’historique pour réutiliser les réglages.
Oui. Le prompt du cas d’usage verrouille les exigences audio, mais vous pouvez ajouter en dessous une nouvelle réplique et la personne qui la prononce. Plus la réplique est courte, plus elle sort claire et bien synchronisée.
L’exemple est en anglais. Certains modèles peuvent générer une voix en chinois, avec des résultats variables : testez une phrase courte avant de générer en masse.
Ce cas d’usage exige des dialogues synchronisés en natif : seuls les modèles qui génèrent de l’audio sont inclus. Les modèles sans audio produisent une vidéo muette.
Non. La vidéo est le plus souvent facturée à la seconde et chaque modèle a ses propres spécifications. Le bouton Exécuter affiche les crédits estimés pour les réglages actuels et se met à jour quand vous changez de modèle.
Oui. Chaque modèle propose une API avec les mêmes paramètres que l’outil web. La page du modèle détaille les paramètres de requête et la documentation pour générer vos vidéos avec son en lot.
Vous pouvez nous joindre via le chat en direct en bas à droite de la page, nous envoyer un e-mail à [email protected], ou rejoindre notre communauté Discord. Notre équipe vous répondra dans les plus brefs délais.