 APIMart Officially Launches seedance-2-5-flash APISeedance 2.5 Flash entdecken: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APISeedance 2.5 Flash entdecken: APIMart Officially Launches seedance-2-5-flash API
KI-Video mit Ton: Erstelle Clips, in denen eine Figur spricht, wobei Dialog, Lippenbewegung und Umgebungsgeräusche gemeinsam entstehen, sodass keine nachträgliche Vertonung nötig ist. Wechsle unten das Modell, vergleiche echte Ergebnisse und generiere mit den Voreinstellungen.
Alle Modelle unten nutzen denselben Prompt, damit du Sprachverständlichkeit, Lippensynchronität und Umgebungsklang direkt vergleichen kannst. Mit „Beispiel verwenden“ lädst du die Einstellungen des Modells ins Tool oben.
Prompt
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
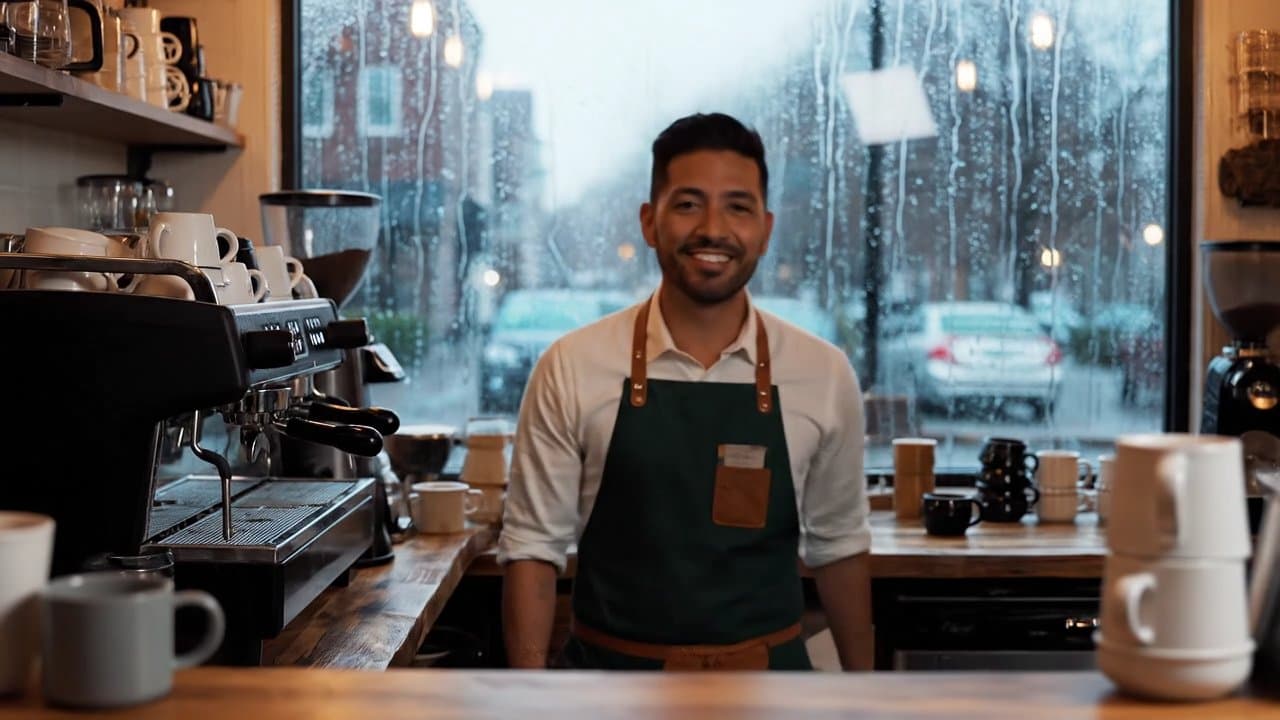
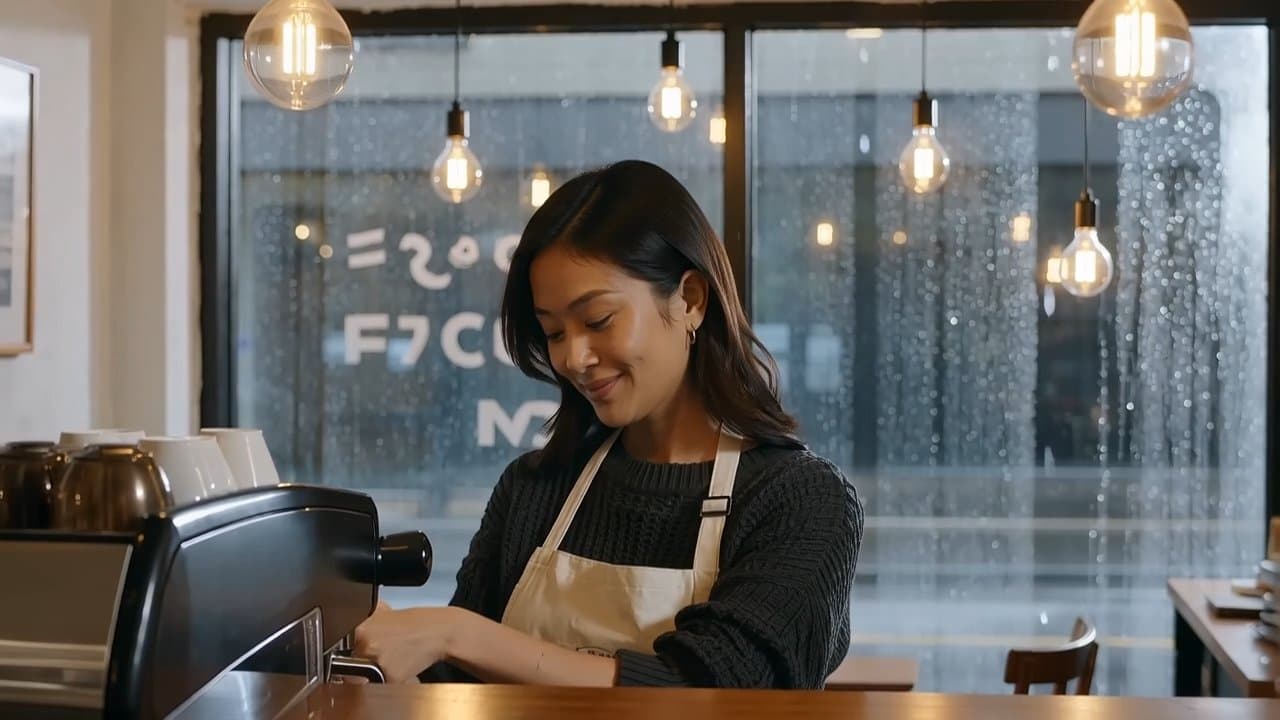
Text zu Video · 16:9 · 720P · 7s
HappyHorse 1.0 APIBeispiel verwenden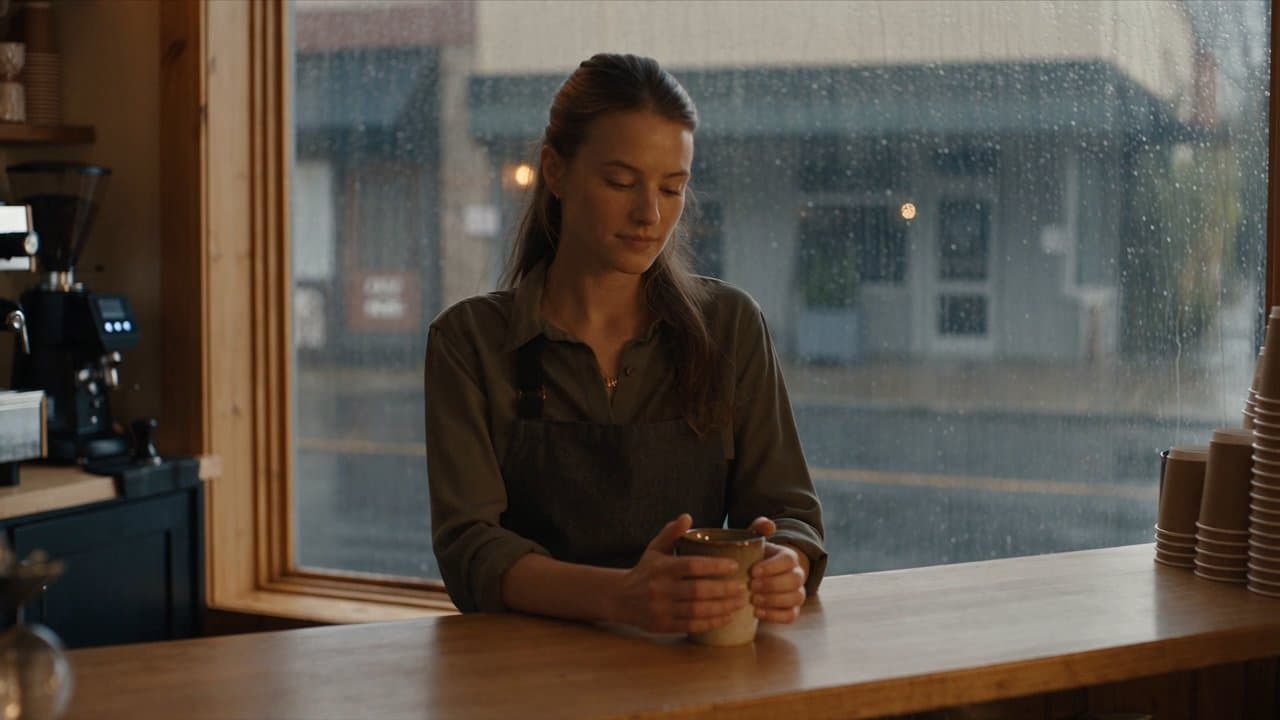
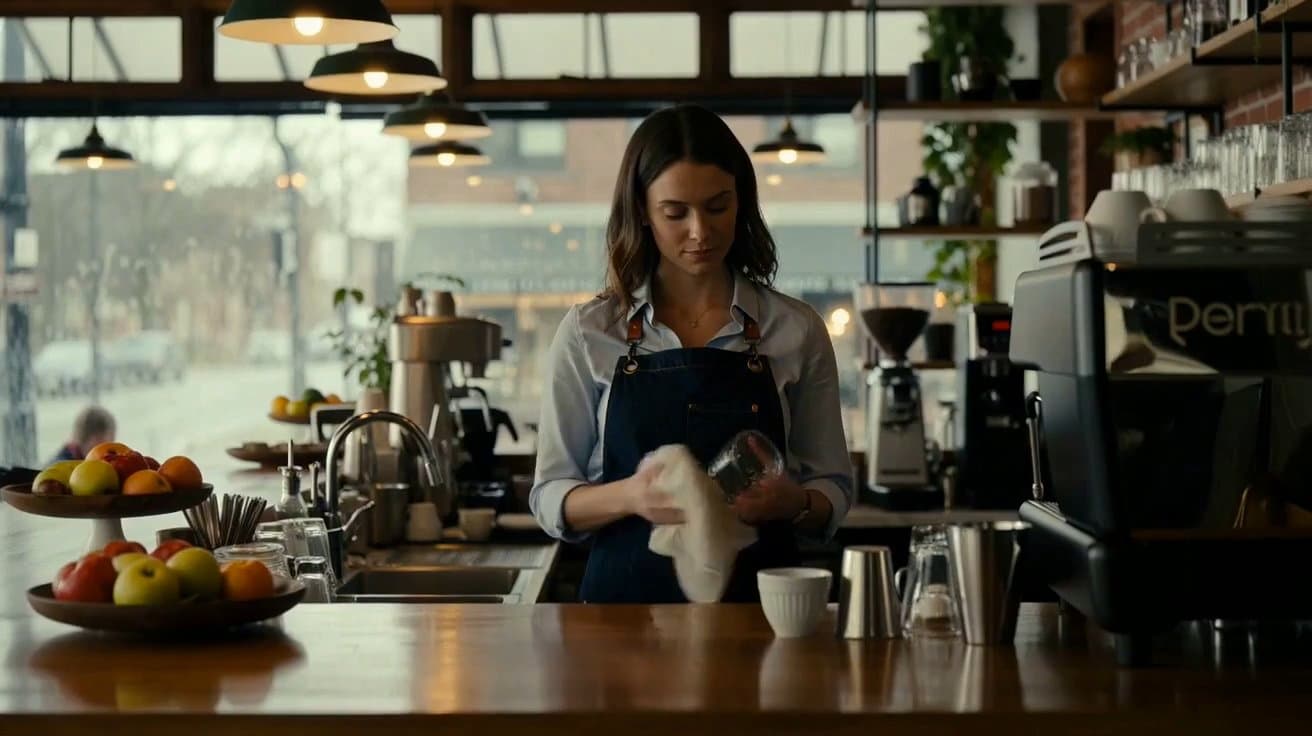
Text zu Video · 16:9 · 720p · 7s
SkyReels V4 Fast APIBeispiel verwenden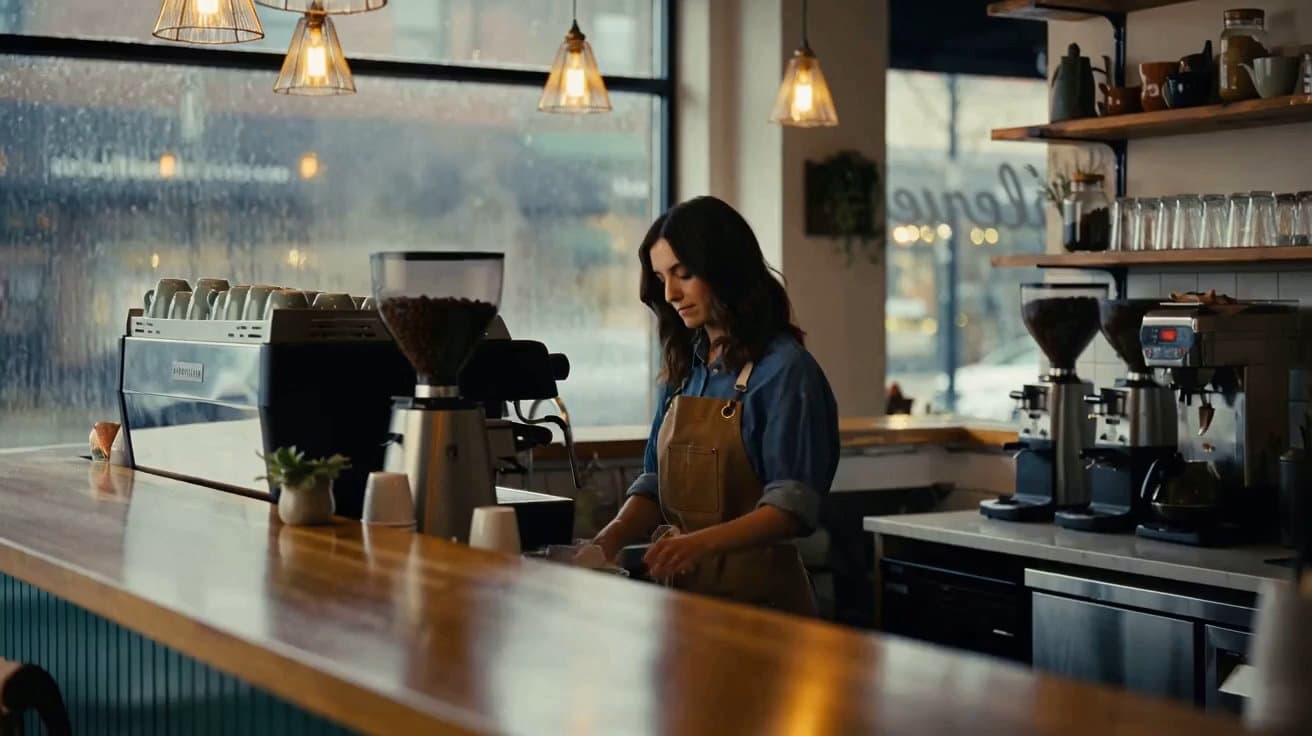
Text zu Video · 16:9 · 720p · 7s
SkyReels V4 Std APIBeispiel verwenden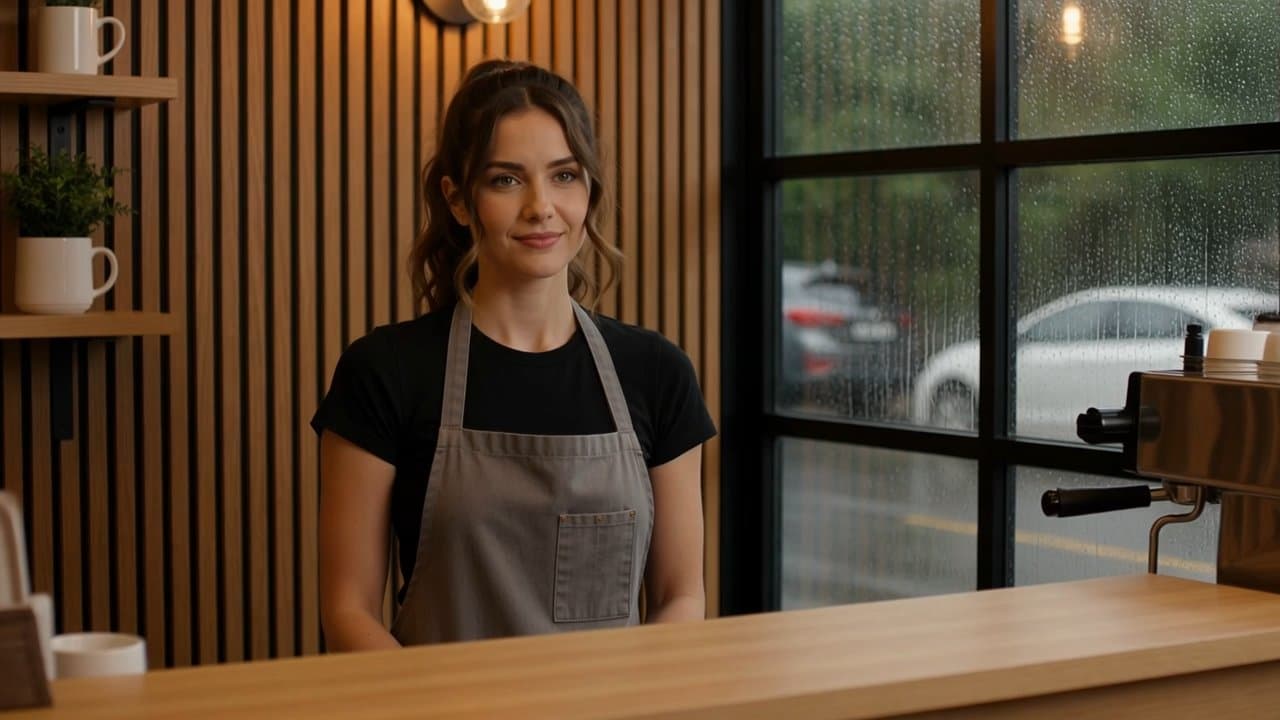
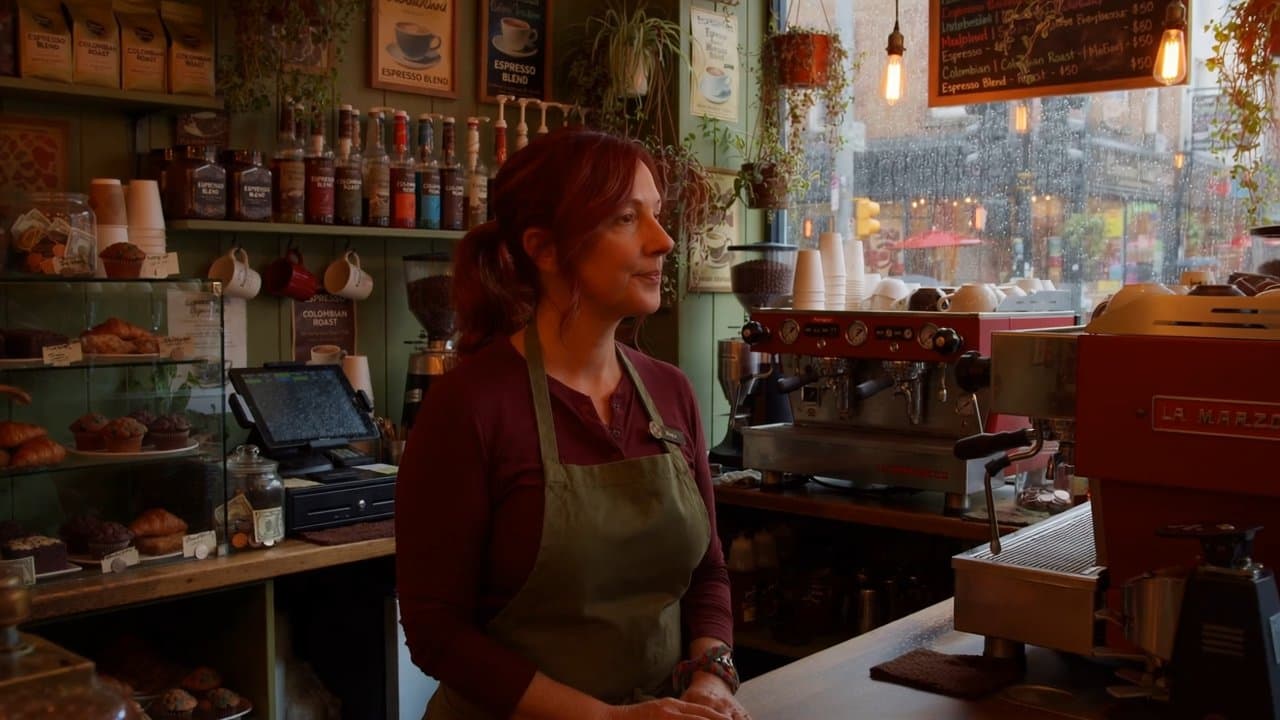
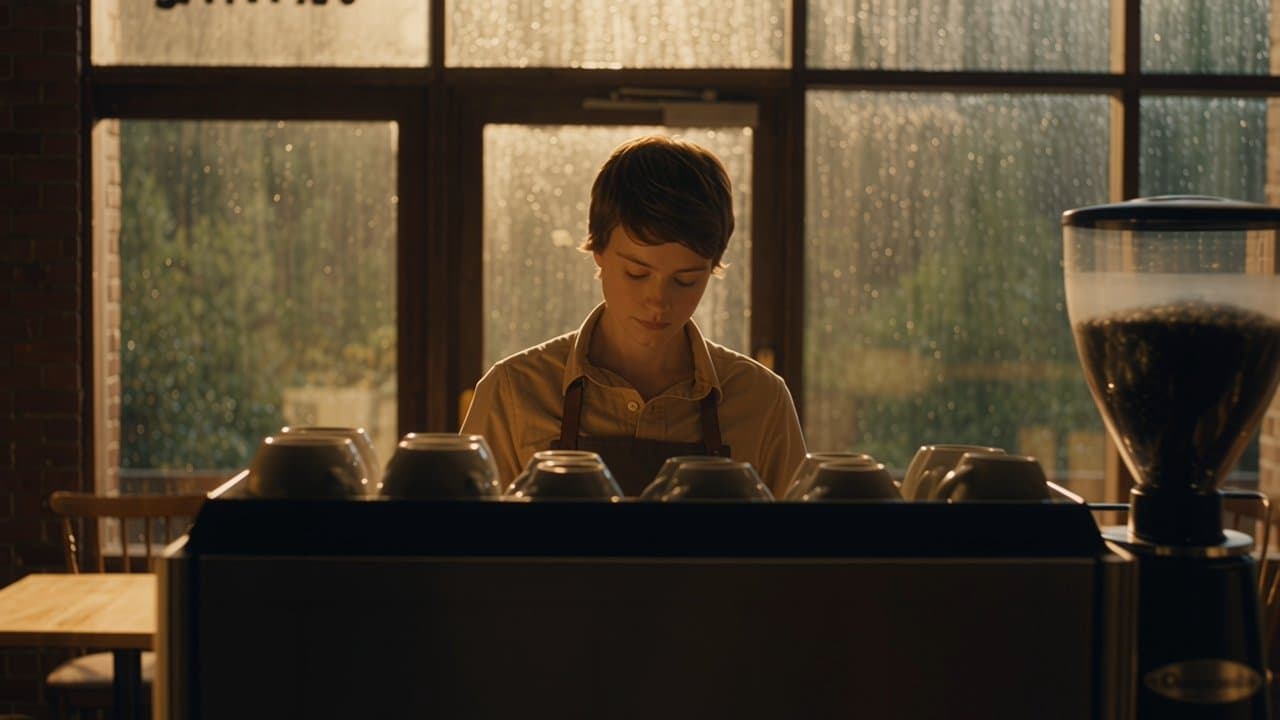
Bei Videos mit nativem Audio entstehen Dialog, Soundeffekte und Atmo zusammen mit dem Bild, die Lippen bewegen sich synchron zur Stimme, und eine separate Vertonung entfällt. Das eignet sich für Werbedialoge, Story-Clips und Social-Media-Inhalte.
Dieser Anwendungsfall zeigt eine Café-Szene, in der hinter der Theke leise der englische Satz „Welcome back.“ fällt, während draußen Regen gegen das Fenster prasselt. Die Voreinstellung verlangt eine einzige sprechende Person mit einem klaren Satz, glaubwürdige Lippenbewegungen und Raumklang, ohne Untertitel und ohne Musik, die die Stimme überdeckt.
Hier sind nur Modelle mit nativem Audio vertreten, und sie unterscheiden sich in Klangqualität und Lippensynchronität. Wechsle oben das Modell, vergleiche die Ergebnisse und wähle das natürlichste.
Jedes Beispiel ist ein echtes Ergebnis der Voreinstellung dieses Anwendungsfalls mit dem jeweiligen Modell. Wechsle oben zum Modell, um es direkt zu nutzen.
| Modell | Stärken | Ideal für |
|---|---|---|
| Veo 3.1 Fast API | Natives Audio synchron zum Bild, Start- und Endbild | Clips mit nativem, synchronem Audio |
| HappyHorse 1.0 API | Standardmäßig natives Audio, Bild-zu-Video aus dem Startbild | Clips mit nativem Audio |
| Seedance 2.5 API | Bis zu 30 Sekunden, erst Entwurf in 480p, dann finale Fassung in 1080p | Lange Einstellungen, vom Entwurf zur finalen Fassung |
| SkyReels V4 Fast API | 480p–1080p, 3–15 Sekunden, Start- und Endbild sowie multimodale Referenzen | Schnelle multimodale Clips |
| SkyReels V4 Std API | Start- und Endbild sowie Omni-Modus mit mehreren Referenzbildern | Omni-Projekte mit mehreren Referenzbildern |
| Kling 4.0 API | Fünf Modi, 720p / 1080p, 3–30 Sekunden, immer mit Stereoton | Lange Clips mit Ton und mehreren Referenzen |
| Muse Video API | Text und Referenzbild zu Video, fest etwa 10 Sekunden in 720p, mit Ton | 10-Sekunden-Clips mit Ton |
| apimart-zoe API | Ton an, aus oder automatisch, 4–30 Sekunden oder Auto, 480p bis 4K | Dialogclips bis 4K, zuerst als 480p-Entwurf |
Wechsle oben das Modell und vergleiche echte Ergebnisse, Spezifikationen und geschätzte Credits für diesen Anwendungsfall.
Der Szenen-Prompt legt Sprecher und Audioanforderungen bereits fest. Ergänze darunter einen neuen Satz, eine Figur und einen Schauplatz.
Klicke auf Ausführen. Ergebnisse erscheinen rechts und lassen sich im Verlauf wiederfinden und erneut verwenden.
Ja. Der Szenen-Prompt ist gesperrt und legt die Audioanforderungen fest, darunter kannst du aber einen neuen Satz und die sprechende Person ergänzen. Je kürzer der Satz, desto klarer und synchroner das Ergebnis.
Das Beispiel nutzt einen englischen Dialog. Einige Modelle können chinesische Sprache erzeugen, die Ergebnisse variieren je nach Modell; teste daher zuerst einen kurzen Satz, bevor du in Serie generierst.
Dieser Anwendungsfall braucht nativ synchronen Dialog, daher sind nur Modelle mit Audio-Generierung dabei. Modelle ohne Audio liefern ein stummes Video.
Nein. Die meisten Videomodelle werden pro Sekunde abgerechnet, und jedes Modell hat eigene Spezifikationen. Die Schaltfläche Ausführen zeigt die geschätzten Credits für die aktuellen Einstellungen und aktualisiert sich beim Modellwechsel.
Ja. Jedes Modell bietet eine API mit denselben Parametern wie das Web-Tool. Auf der Modellseite findest du Anfrageparameter und Dokumentation, um Videos mit Ton in großen Mengen zu erzeugen.
Sie erreichen uns über den Live-Chat unten rechts auf der Seite, per E-Mail an [email protected] oder über unsere Discord-Community. Unser Team wird sich so schnell wie möglich bei Ihnen melden.