 APIMart Officially Launches seedance-2-5-flash APISeedance 2.5 Flash 살펴보기: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APISeedance 2.5 Flash 살펴보기: APIMart Officially Launches seedance-2-5-flash API
AI 음성 포함 영상 생성: 인물이 말하는 영상을 대사, 입 모양, 환경음까지 한 번에 생성해 후반 더빙이 필요 없습니다. 아래에서 모델을 전환해 실제 결과를 비교하고 미리 설정된 값으로 바로 생성하세요.
아래 모델은 모두 같은 프롬프트로 생성해 대사 명료도, 립싱크, 환경음을 바로 비교할 수 있습니다. '이 예시 사용'을 누르면 해당 모델의 설정을 위 도구에 불러옵니다.
프롬프트
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
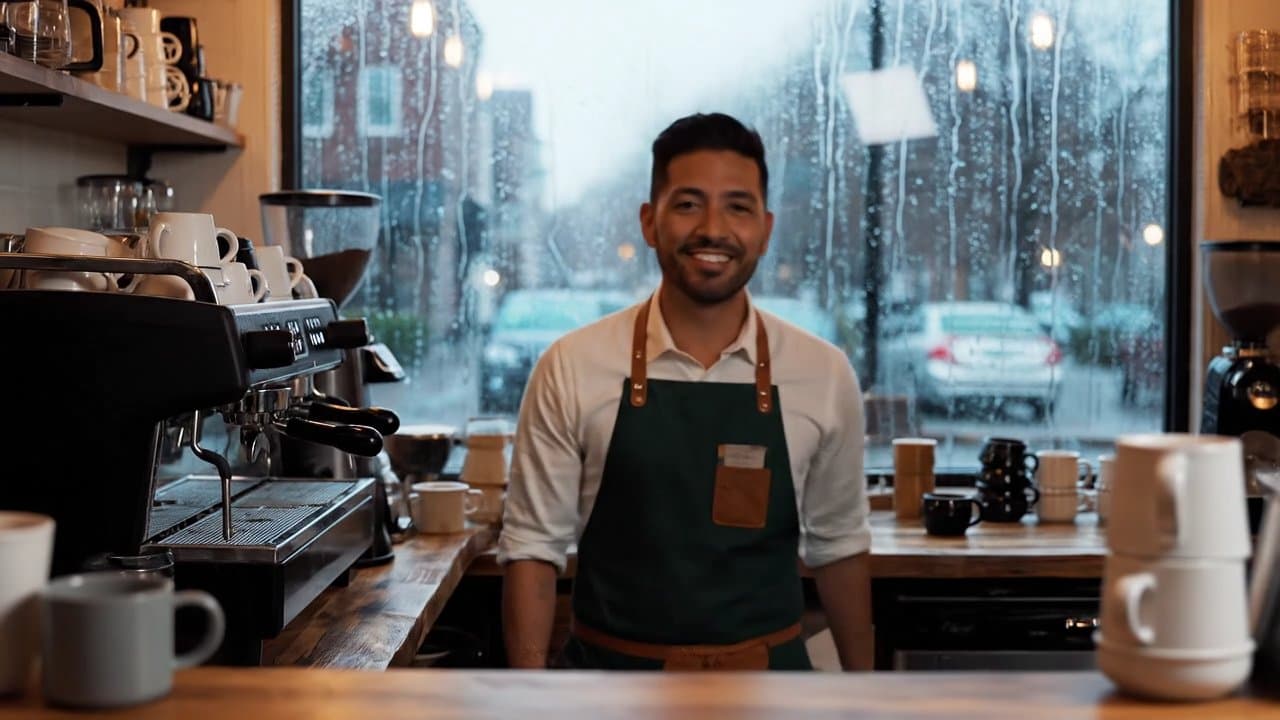
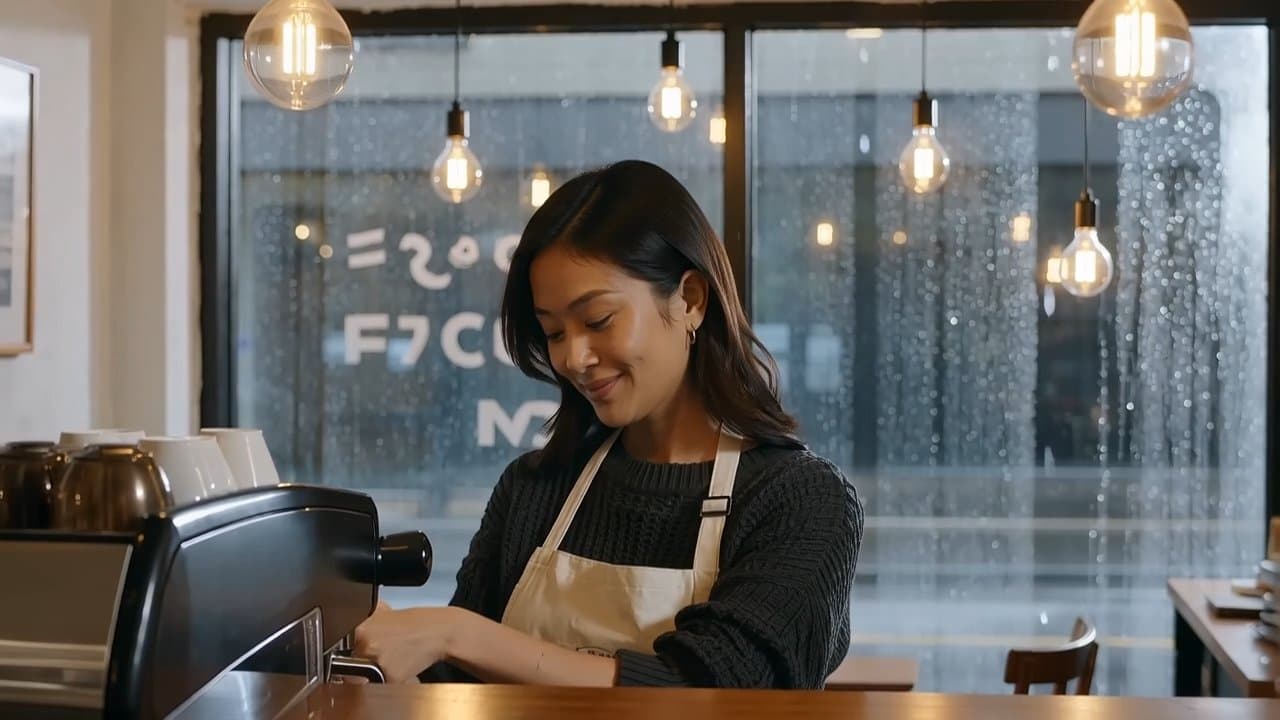
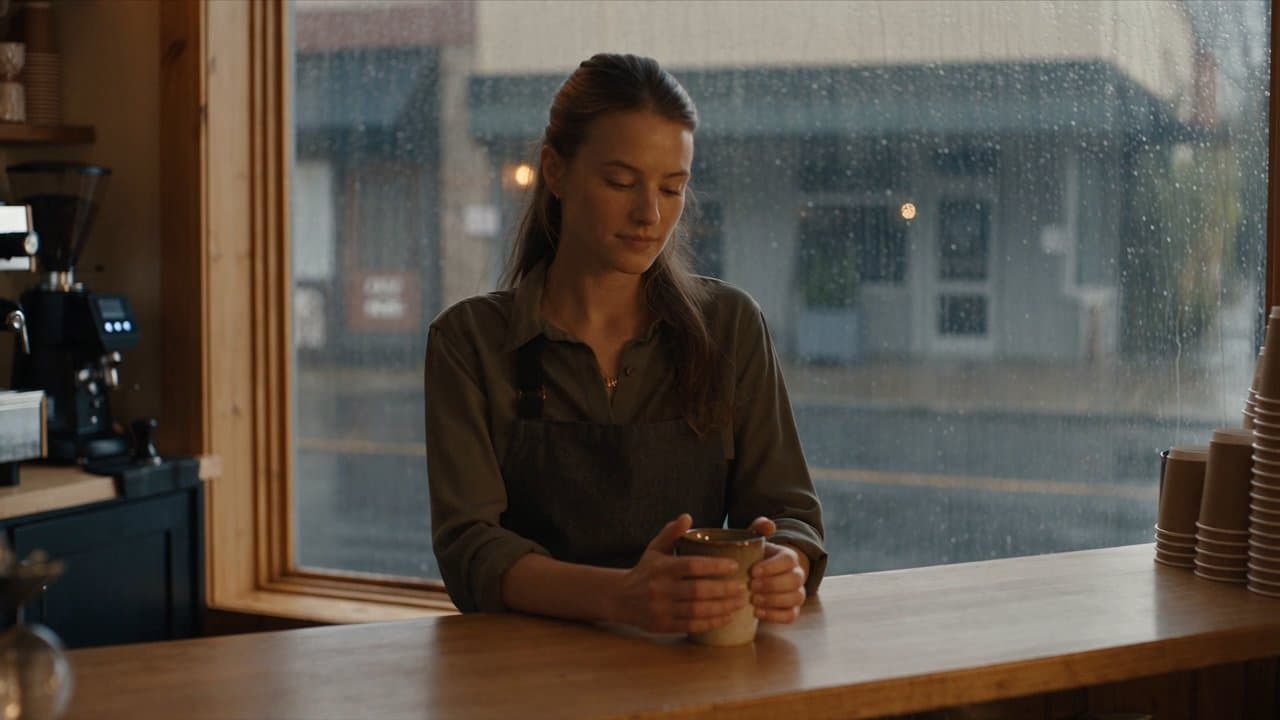
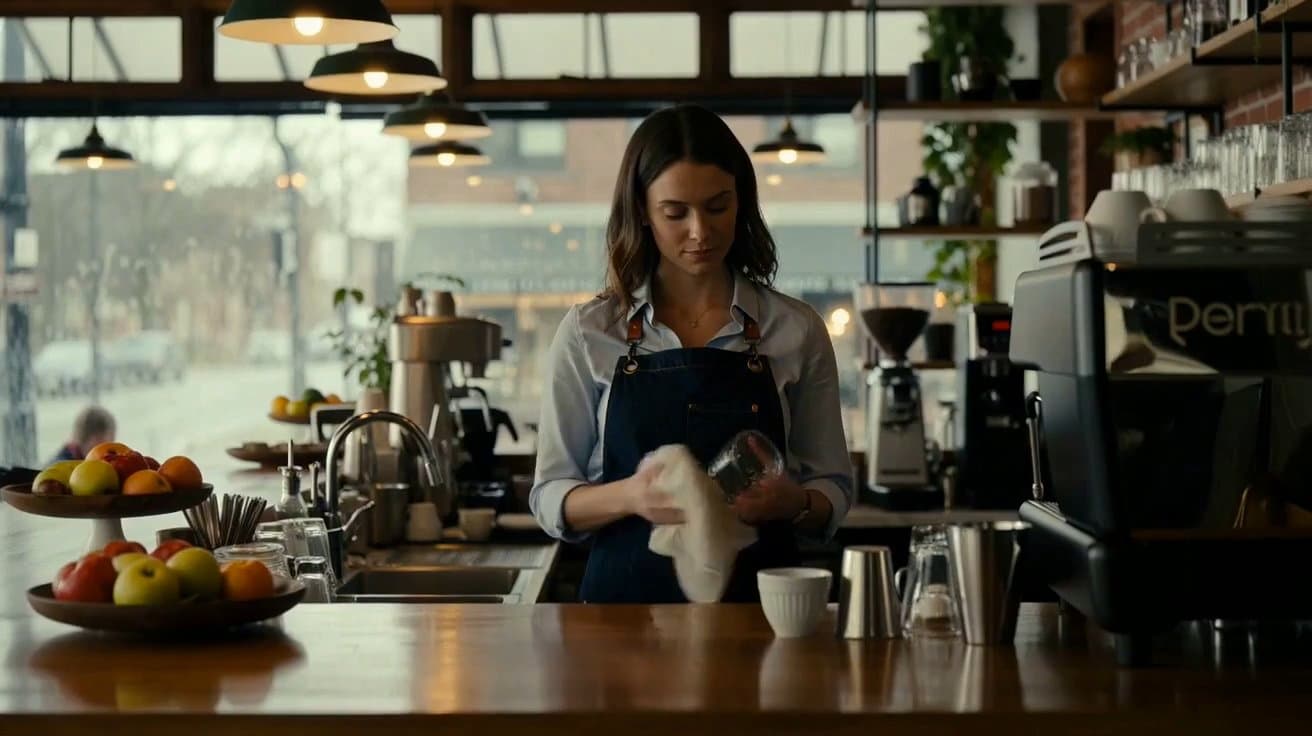
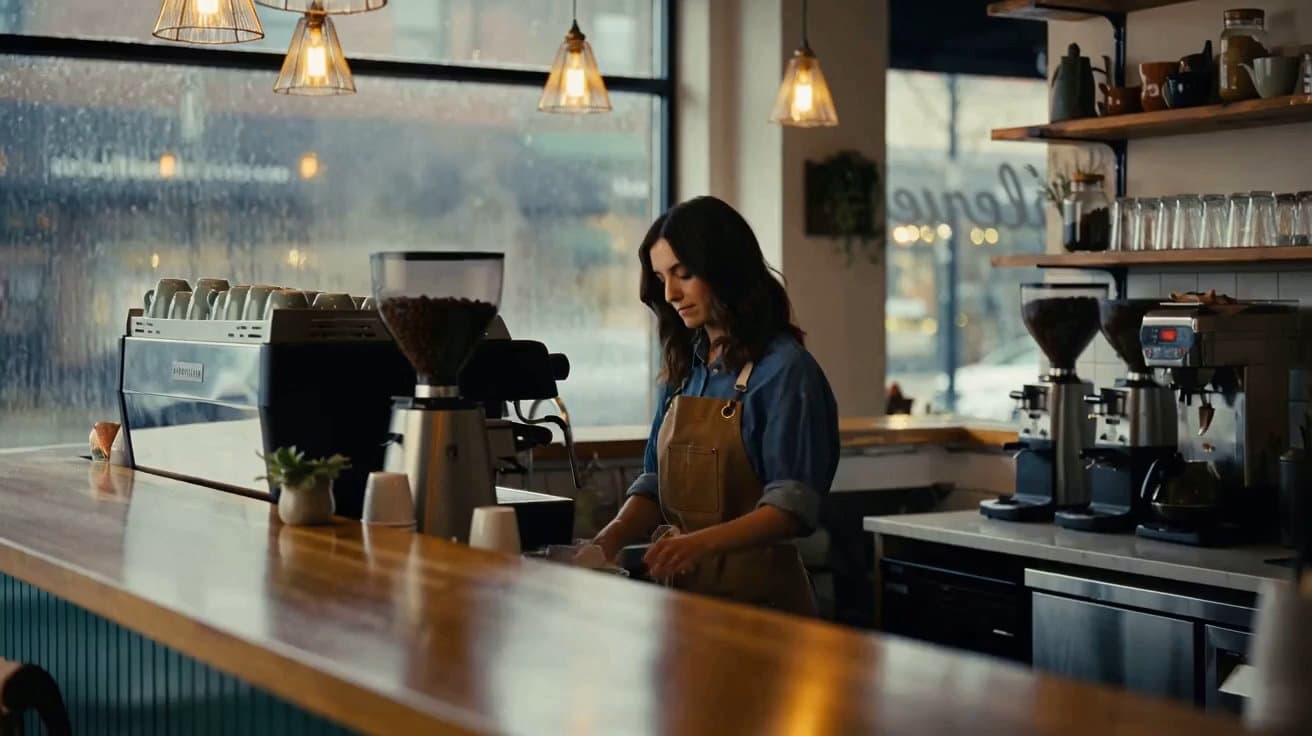
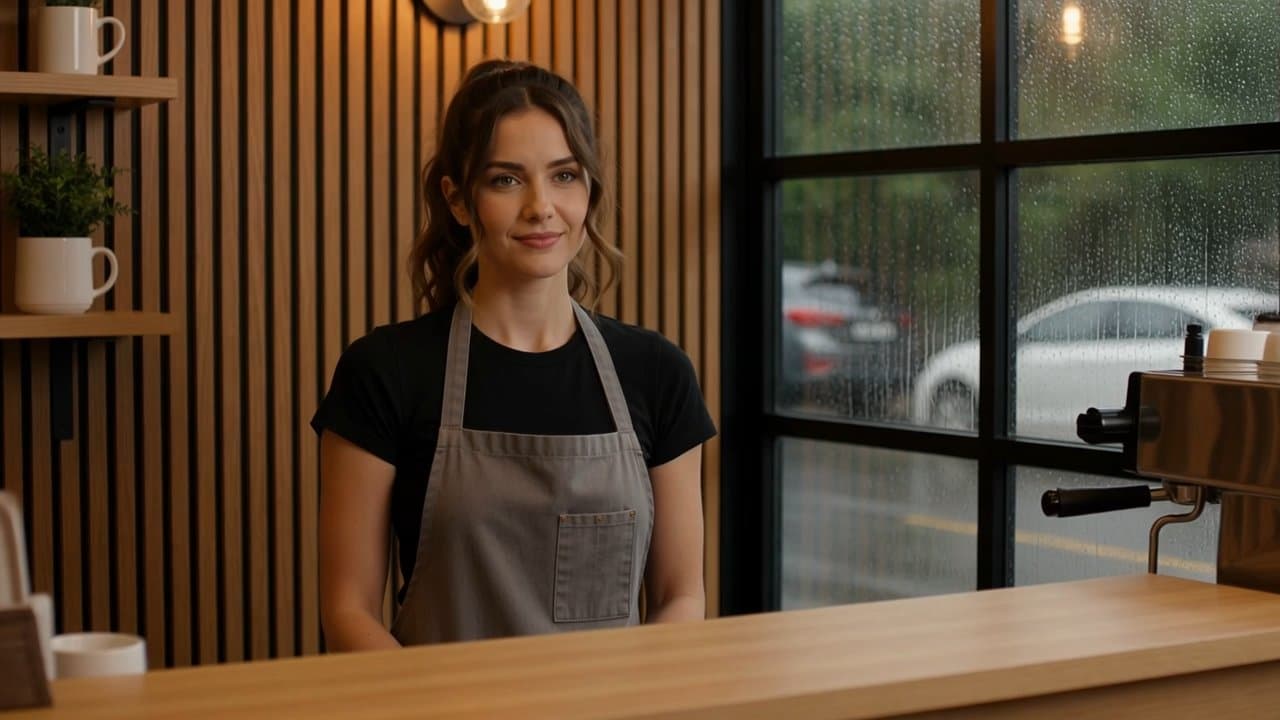
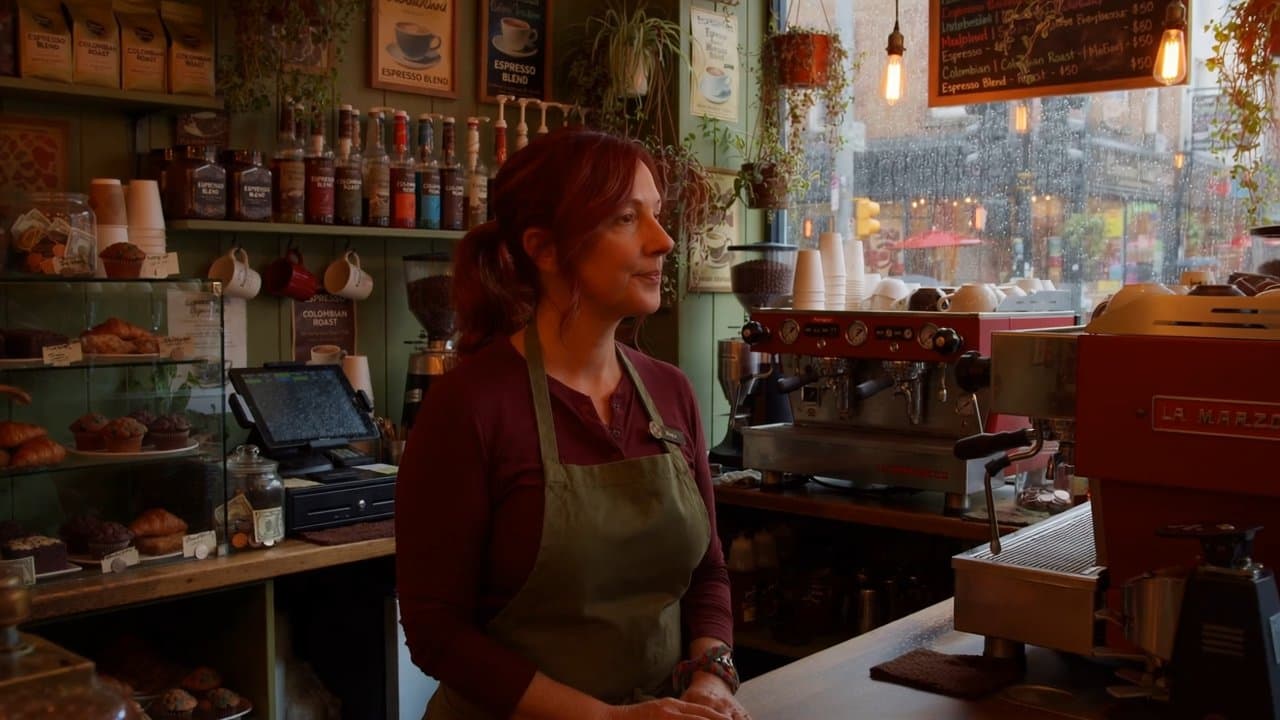
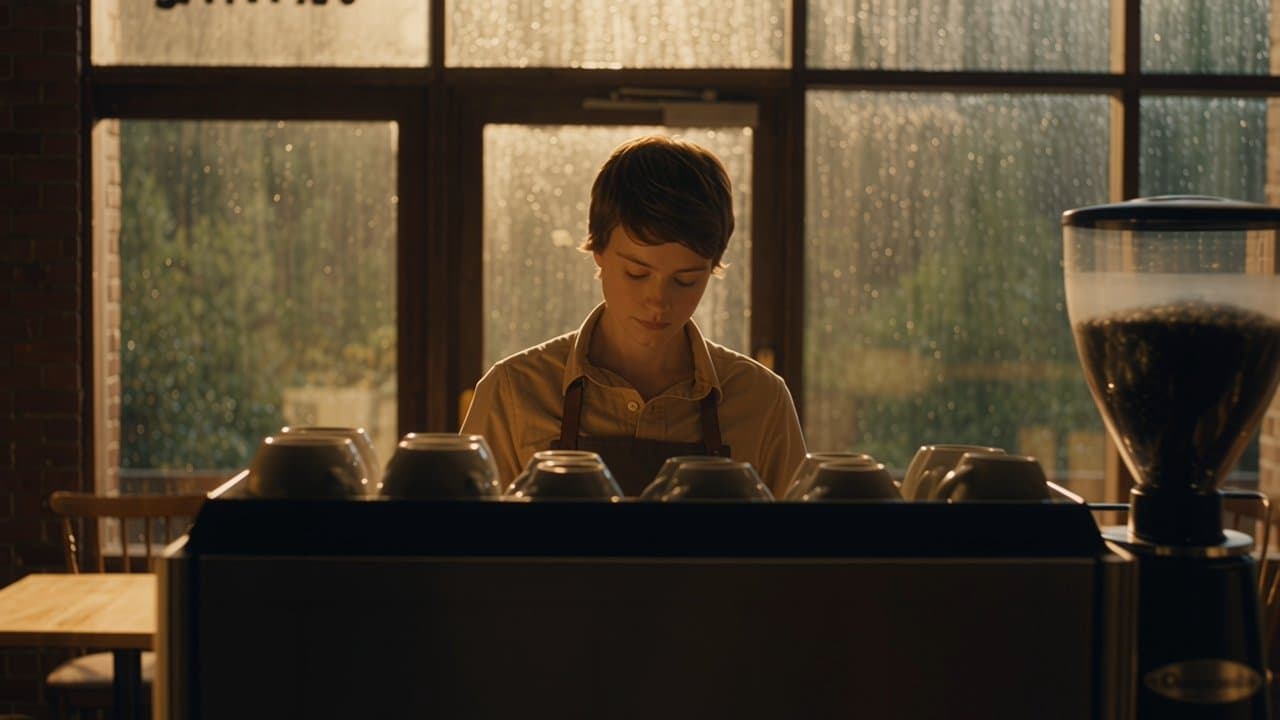
네이티브 오디오 영상은 화면과 함께 대사, 효과음, 환경음을 생성하고 입 모양과 목소리를 맞춰 후반 더빙이 필요 없습니다. 광고 대사, 스토리 영상, SNS 콘텐츠에 적합합니다.
이 용도는 바리스타를 예로 듭니다. 창밖에 비가 내리고 바리스타가 영어 대사 “Welcome back.”을 나지막이 말합니다. 프리셋은 화자 한 명, 또렷한 대사 한 줄, 자연스러운 입 모양, 실내 환경음을 요구하며 자막은 넣지 않고 음악이 목소리를 덮지 않도록 지시합니다.
이 용도에는 네이티브 오디오를 지원하는 모델만 담았으며, 음질과 립싱크에서 차이가 납니다. 위에서 모델을 전환해 비교하고 가장 자연스러운 모델을 고르세요.
아래 예시는 모두 이 용도의 프리셋을 각 모델로 실제 생성한 결과입니다. 위에서 해당 모델로 전환하면 바로 사용할 수 있습니다.
| 모델 | 강점 | 추천 용도 |
|---|---|---|
| Veo 3.1 Fast API | 네이티브 오디오를 화면과 동시에 생성, 첫/마지막 프레임 지원 | 네이티브 음성과 화면이 동기화된 짧은 영상 |
| HappyHorse 1.0 API | 기본으로 네이티브 오디오 생성, 첫 프레임 이미지→영상 지원 | 네이티브 오디오가 있는 짧은 영상 |
| Seedance 2.5 API | 최대 30초, 480p 샘플 후 1080p 본편으로 전환 가능 | 롱테이크와 샘플에서 본편으로 전환 |
| SkyReels V4 Fast API | 480p–1080p, 3–15초, 첫/마지막 프레임과 멀티모달 참고 지원 | 빠른 멀티모달 짧은 영상 |
| SkyReels V4 Std API | 첫/마지막 프레임과 여러 참고 이미지를 쓰는 Omni 모드 지원 | 여러 참고 이미지를 쓰는 Omni 제작 |
| Kling 4.0 API | 5가지 모드, 720p / 1080p, 3–30초, 항상 스테레오 오디오 포함 | 여러 소재를 참조하는 음성 포함 긴 영상 |
| Muse Video API | 텍스트·참조 이미지 영상 생성, 약 10초·720p 고정, 소리 포함 | 소리가 있는 10초 영상 |
| apimart-zoe API | 오디오 켜기·끄기·자동 선택, 4–30초 또는 자동 길이, 480p부터 4K | 480p 초안부터 최대 4K까지 만드는 대사 영상 |
위에서 모델을 전환해 이 용도의 실제 결과, 사양, 예상 크레딧을 비교하세요.
장면 프롬프트에 화자와 오디오 조건이 설정되어 있습니다. 그 아래에 새 대사, 인물, 장면을 추가하세요.
실행을 누르면 생성이 시작되고 결과가 오른쪽에 표시됩니다. 작업 기록에서 다시 찾아 설정을 재사용할 수도 있습니다.
네. 장면 프롬프트는 오디오 조건이 고정되어 있지만 그 아래에 새 대사와 화자를 추가할 수 있습니다. 대사가 짧을수록 또렷하고 싱크가 잘 맞습니다.
예시는 영어 대사입니다. 일부 모델은 중국어 음성도 생성할 수 있지만 결과는 모델마다 다르므로, 짧은 문장으로 먼저 테스트한 뒤 일괄 생성하세요.
이 용도는 네이티브로 동기화된 대사가 필요해 오디오 생성을 지원하는 모델만 담았습니다. 오디오를 지원하지 않는 모델은 무음 영상을 생성합니다.
아니요. 영상은 대부분 초 단위로 과금되며 모델마다 사양이 다릅니다. 실행 버튼에 현재 설정의 예상 크레딧이 표시되며 모델을 전환하면 자동으로 갱신됩니다.
네. 각 모델은 웹 도구와 같은 파라미터의 API를 제공합니다. 모델 페이지에서 요청 파라미터와 문서를 확인할 수 있어 음성 포함 영상 일괄 생성에 적합합니다.
페이지 오른쪽 하단의 실시간 채팅, [email protected] 이메일, 또는 Discord 커뮤니티를 통해 문의하실 수 있습니다. 최대한 빠르게 답변드리겠습니다.