 APIMart Officially Launches seedance-2-5-flash APIJelajahi Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APIJelajahi Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash API
Pembuat video AI dengan suara: buat klip karakter yang berbicara, dengan dialog, gerak bibir, dan suara lingkungan yang dibuat bersamaan, tanpa perlu sulih suara terpisah. Ganti model di bawah untuk membandingkan hasil nyata, lalu buat dengan pengaturan yang sudah disiapkan.
Semua model di bawah memakai prompt yang sama, sehingga kejelasan dialog, sinkronisasi bibir, dan suara lingkungan bisa dibandingkan langsung. Klik Gunakan contoh ini untuk memuat pengaturan model tersebut ke alat di atas.
Prompt
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
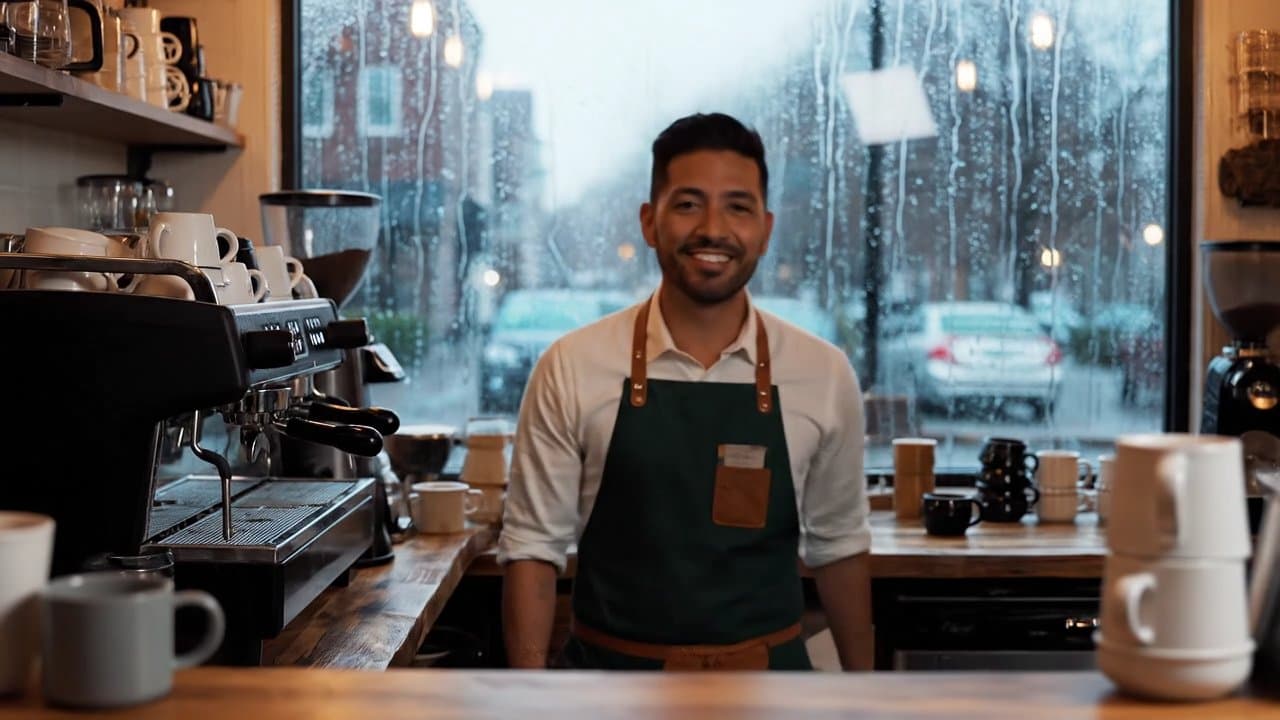
Teks ke video · 16:9 · 720p · 8s
Veo 3.1 Fast APIGunakan contoh ini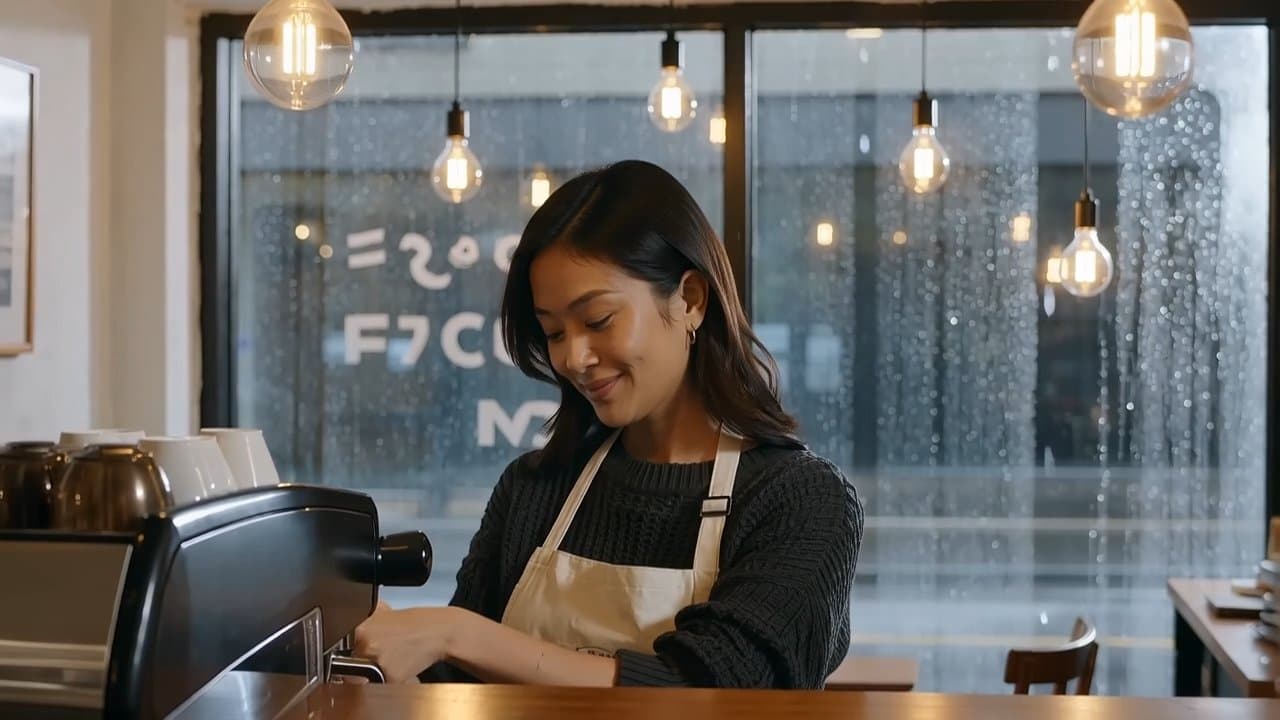
Teks ke video · 16:9 · 720P · 7s
HappyHorse 1.0 APIGunakan contoh ini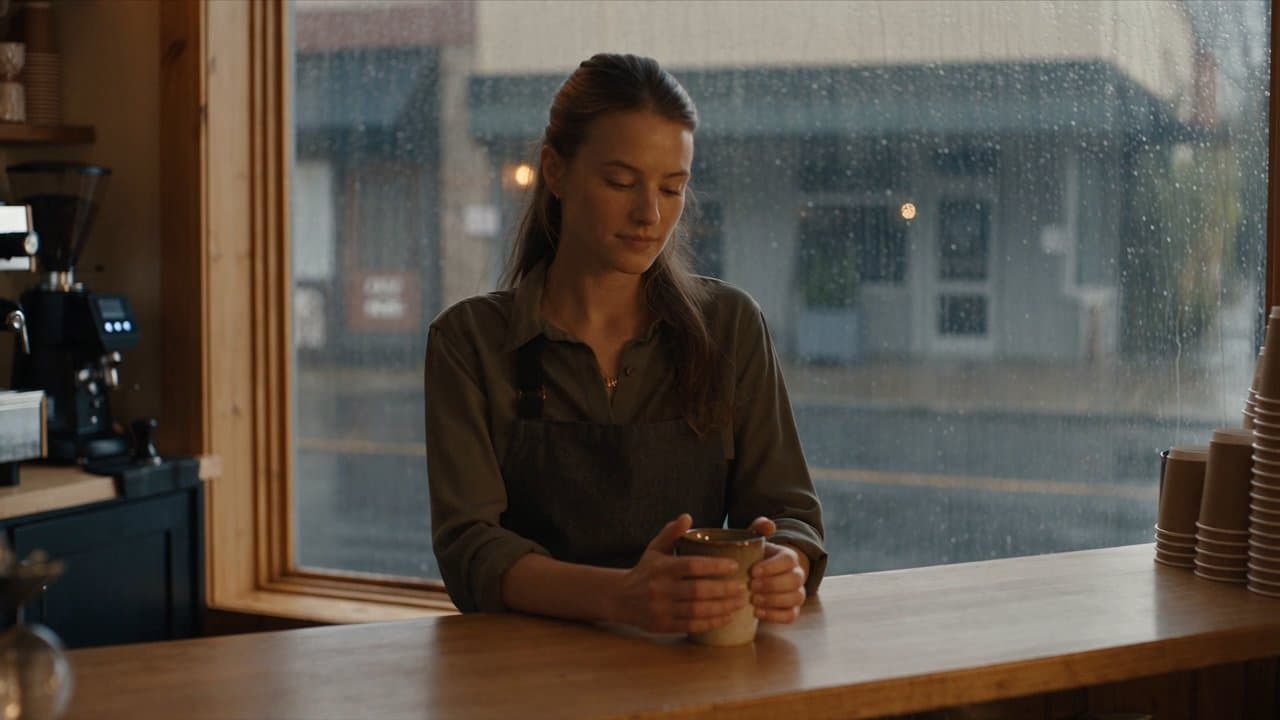
Teks ke video · 16:9 · 720p · 7s
Seedance 2.5 APIGunakan contoh ini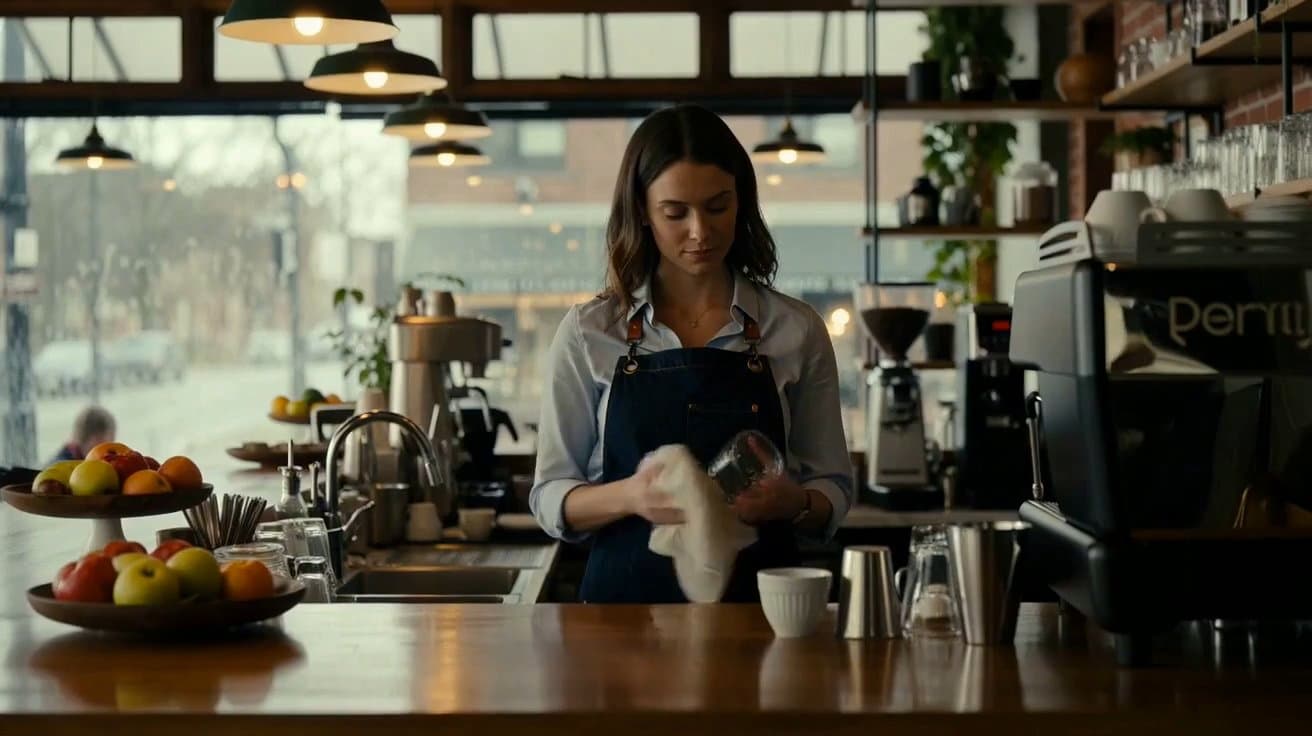
Teks ke video · 16:9 · 720p · 7s
SkyReels V4 Fast APIGunakan contoh ini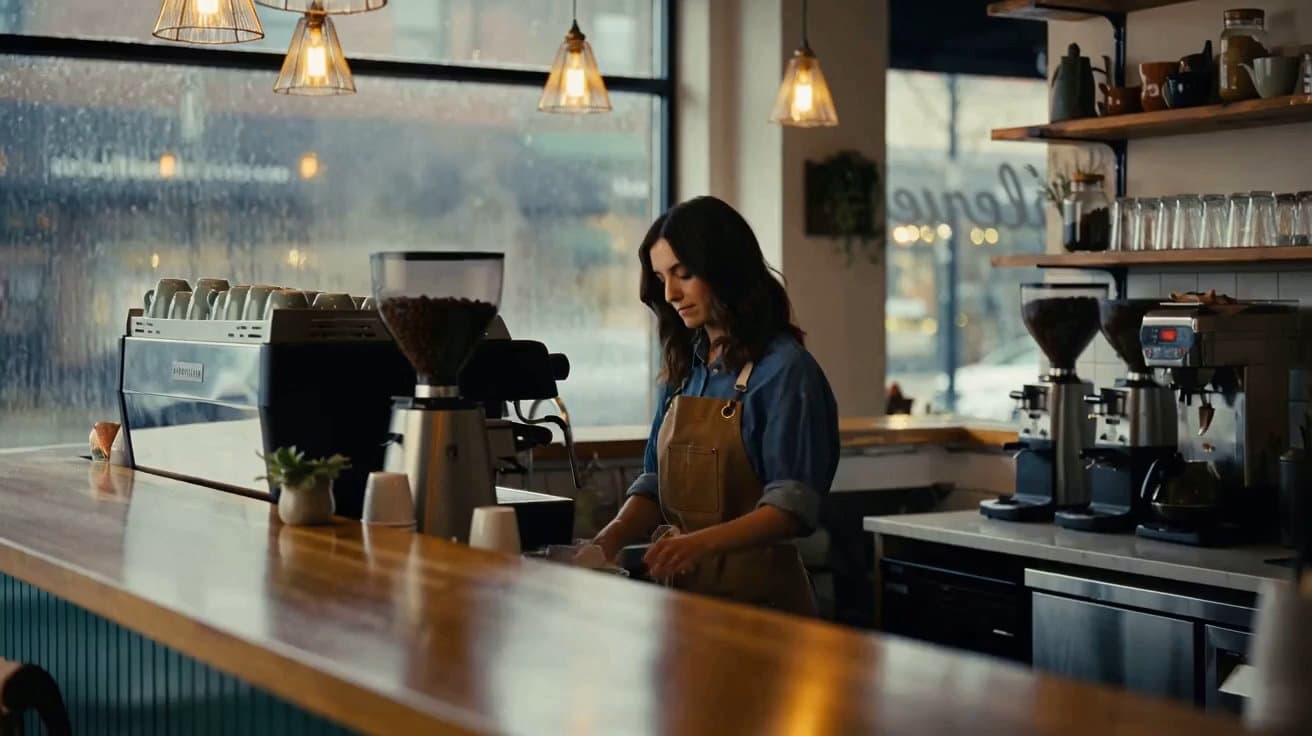
Teks ke video · 16:9 · 720p · 7s
SkyReels V4 Std APIGunakan contoh ini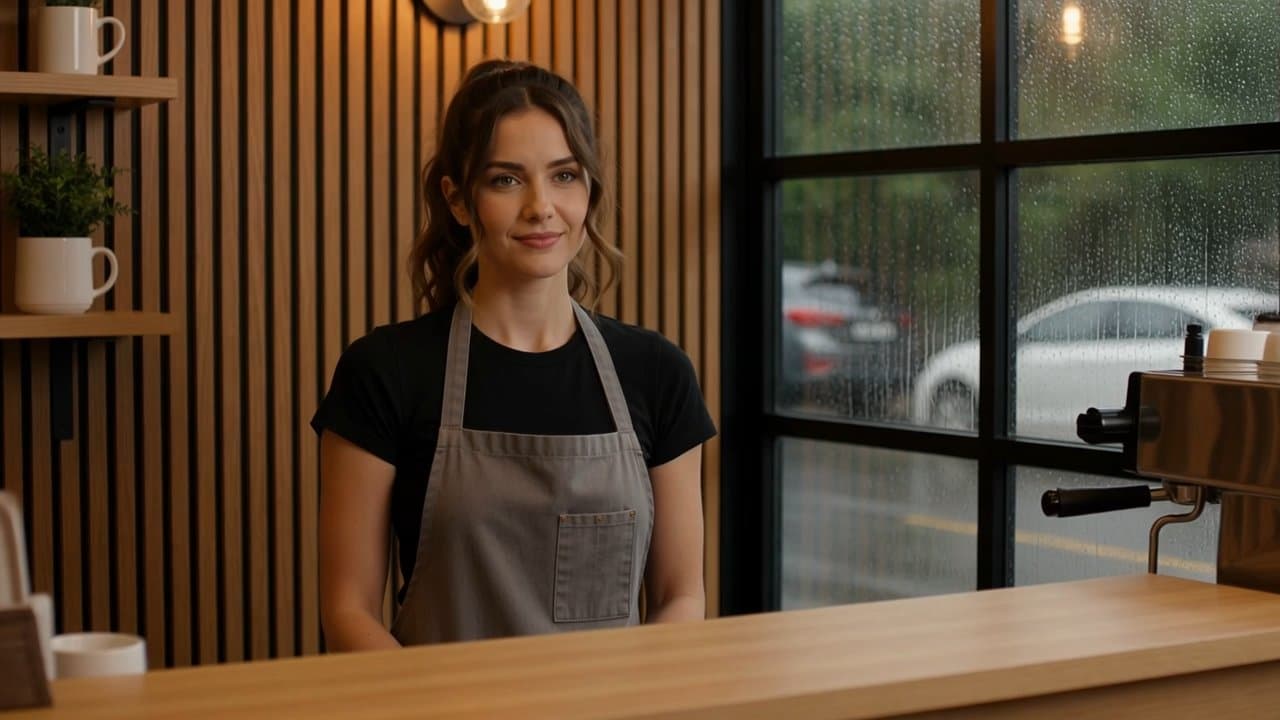
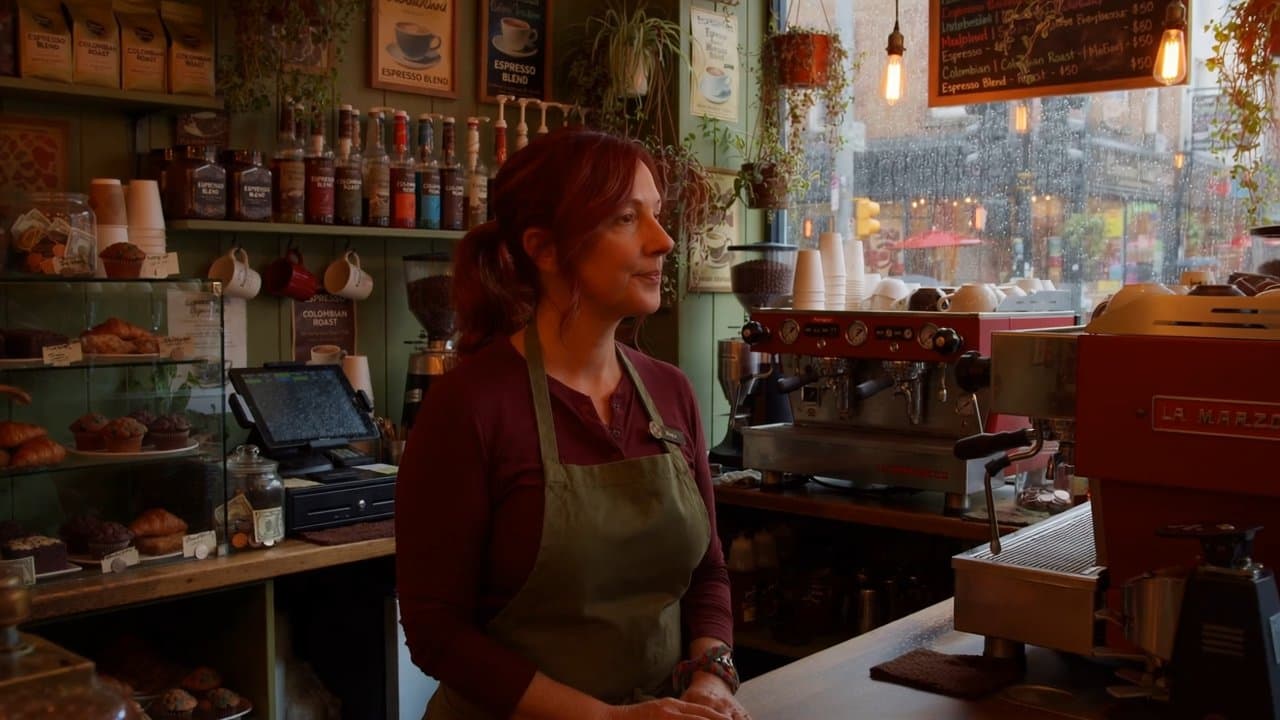
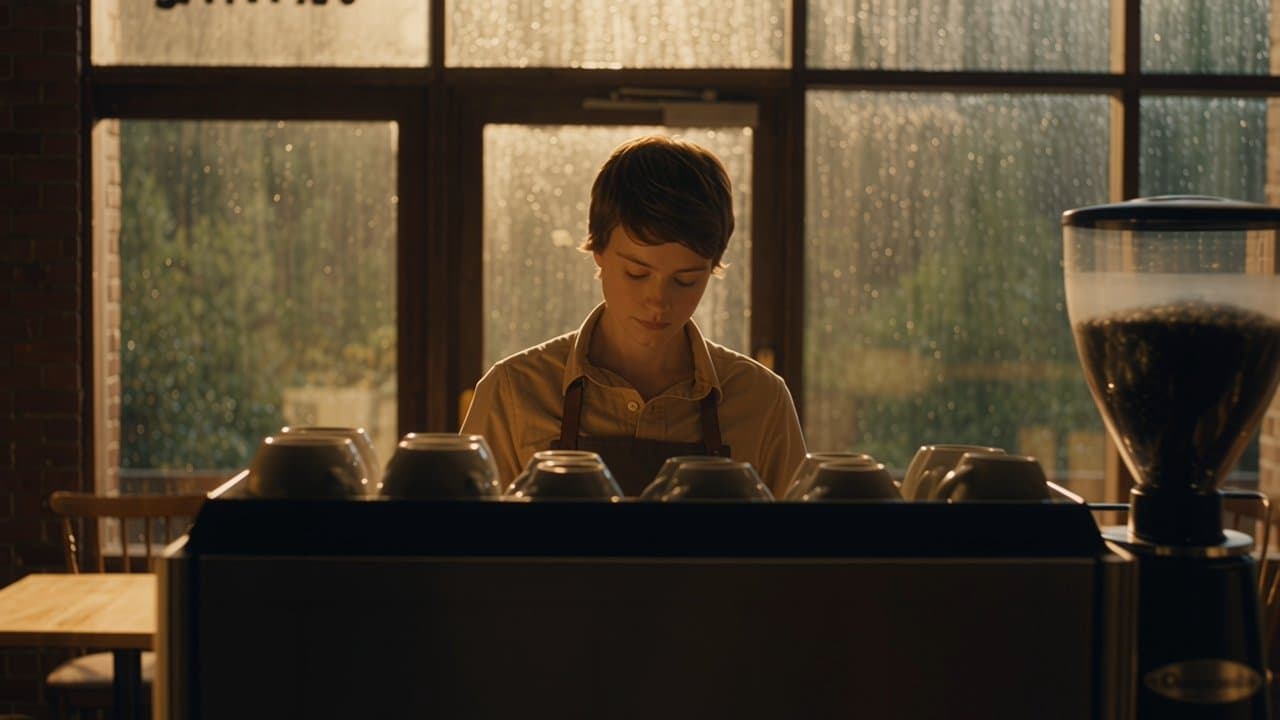
Video dengan audio native membuat dialog, efek suara, dan suara lingkungan bersamaan dengan gambarnya, dengan gerak bibir yang sinkron, sehingga tidak perlu sulih suara terpisah. Cocok untuk dialog iklan, klip cerita, dan konten media sosial.
Kasus ini memakai seorang barista sebagai contoh: di luar jendela hujan turun, dan ia mengucapkan dialog berbahasa Inggris “Welcome back.” dengan lembut. Preset meminta hanya satu pembicara dan satu kalimat yang jelas, gerak bibir yang meyakinkan, serta suara ruangan, tanpa subtitle dan tanpa musik yang menutupi suara.
Kasus ini hanya memuat model yang mendukung audio native, dan kualitas suara serta sinkronisasi bibirnya berbeda-beda. Ganti model di atas untuk membandingkan, lalu pilih yang paling alami.
Setiap contoh di bawah adalah hasil nyata preset kasus ini pada model tersebut. Pilih model di atas untuk langsung menggunakannya.
| Model | Keunggulan | Cocok untuk |
|---|---|---|
| Veo 3.1 Fast API | Audio native dibuat sinkron dengan gambar, mendukung frame awal dan akhir | Klip dengan audio native yang sinkron |
| HappyHorse 1.0 API | Audio native aktif secara default, mendukung gambar ke video dari frame pertama | Klip dengan audio native |
| Seedance 2.5 API | Hingga 30 detik, bisa membuat draf 480p dulu lalu versi final 1080p | Shot panjang, dari draf ke versi final |
| SkyReels V4 Fast API | 480p–1080p, 3–15 detik, mendukung frame awal dan akhir serta referensi multimodal | Klip multimodal yang cepat |
| SkyReels V4 Std API | Mendukung frame awal dan akhir serta mode Omni dengan beberapa gambar referensi | Kreasi Omni dengan beberapa gambar referensi |
| Kling 4.0 API | Lima mode, 720p / 1080p, 3–30 detik, selalu dengan audio stereo | Klip panjang bersuara dengan banyak referensi |
| Muse Video API | Teks dan gambar referensi ke video, tetap sekitar 10 detik dan 720p, dengan suara | Klip 10 detik bersuara |
| apimart-zoe API | Audio aktif, nonaktif, atau otomatis, durasi 4–30 detik atau otomatis, 480p hingga 4K | Klip dialog hingga 4K, diawali draf 480p |
Ganti model di atas untuk membandingkan hasil nyata, spesifikasi, dan perkiraan kredit untuk kasus ini.
Prompt skenario sudah mengatur pembicara dan kebutuhan audio. Tambahkan dialog, karakter, dan latar baru di bawahnya.
Klik Jalankan untuk membuat. Hasil muncul di kanan dan bisa ditemukan lagi di Riwayat untuk memakai ulang pengaturan.
Bisa. Prompt skenario sudah mengunci kebutuhan audio, dan Anda bisa menambahkan dialog serta pembicara baru di bawahnya. Makin pendek dialognya, makin jelas dan sinkron hasilnya.
Contoh ini memakai dialog berbahasa Inggris. Beberapa model bisa membuat suara berbahasa Mandarin dengan hasil yang berbeda-beda, jadi uji dulu dengan kalimat pendek sebelum membuat secara massal.
Kasus ini membutuhkan dialog native yang sinkron, jadi hanya model yang bisa membuat audio yang dimasukkan; model tanpa dukungan audio menghasilkan video tanpa suara.
Tidak. Sebagian besar video ditagih per detik, dan setiap model punya spesifikasi sendiri. Tombol Jalankan menampilkan perkiraan kredit untuk pengaturan saat ini dan diperbarui otomatis saat Anda mengganti model.
Bisa. Setiap model menyediakan API dengan parameter yang sama seperti alat web. Buka halaman model untuk melihat parameter permintaan dan dokumentasinya, cocok untuk membuat video bersuara dalam jumlah banyak.
Anda dapat menghubungi kami melalui live chat di pojok kanan bawah halaman, email ke [email protected], atau bergabung dengan komunitas Discord kami. Tim kami akan merespons Anda secepat mungkin.