 APIMart Officially Launches seedance-2-5-flash APIExplorar Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash APIAPIMart Officially Launches seedance-2-5-flash APIExplorar Seedance 2.5 Flash: APIMart Officially Launches seedance-2-5-flash API
Vídeo IA con audio: crea clips en los que un personaje habla, con el diálogo, el movimiento de los labios y el sonido ambiente generados a la vez, sin necesidad de doblaje posterior. Cambia de modelo abajo, compara resultados reales y genera con la configuración preparada.
Todos los modelos usan el mismo prompt para que compares directamente la claridad de la voz, la sincronía labial y el sonido ambiente. Pulsa «Usar este ejemplo» para cargar la configuración de ese modelo en la herramienta de arriba.
Prompt
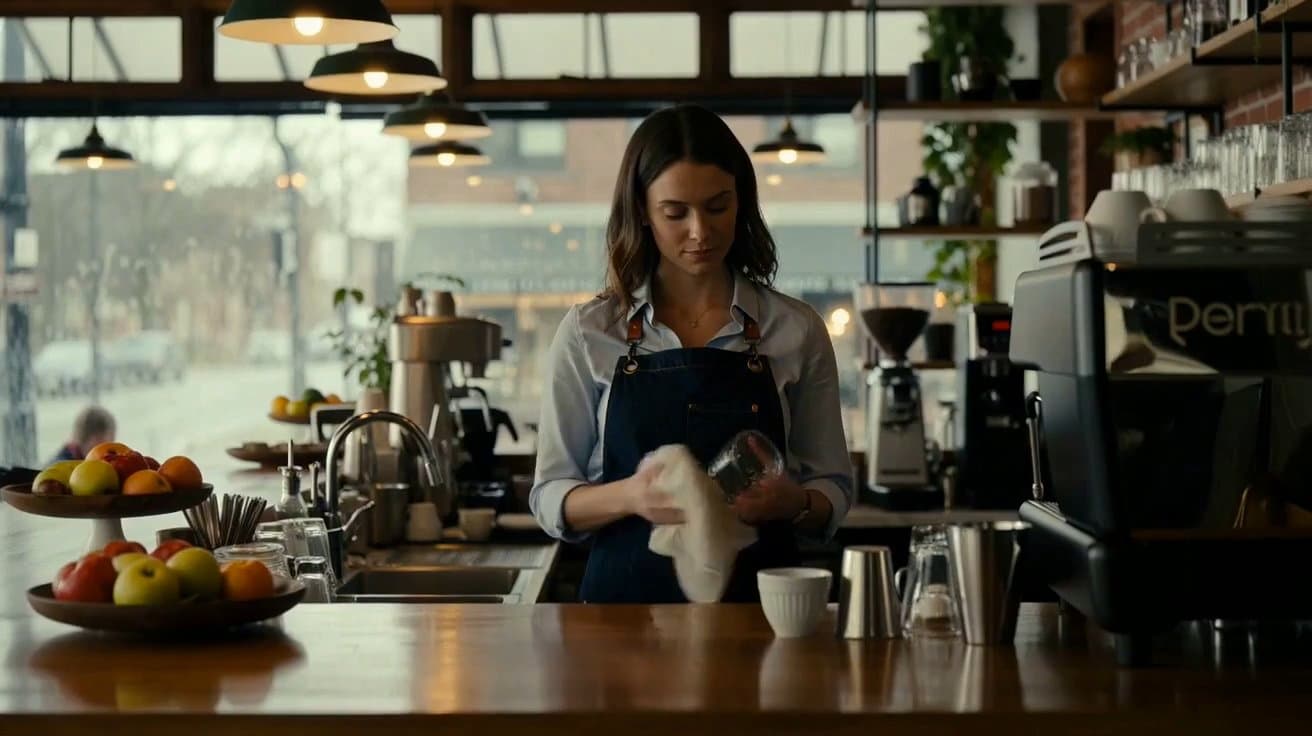
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
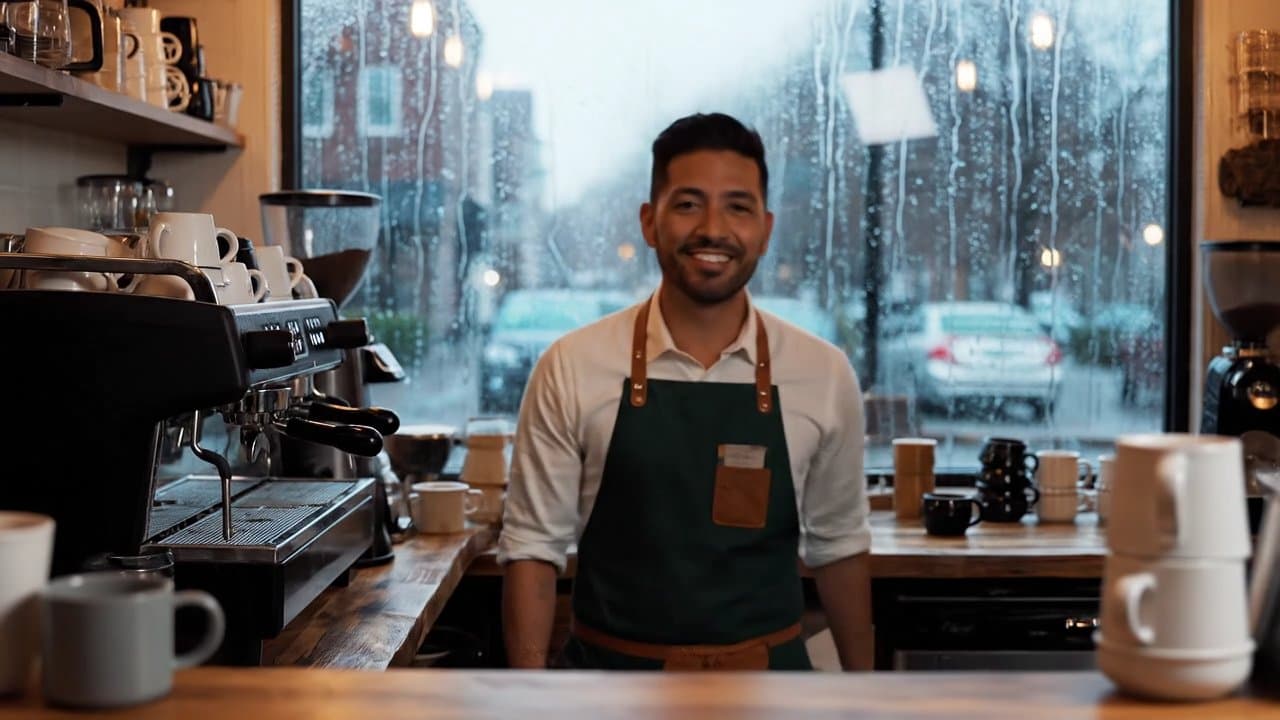
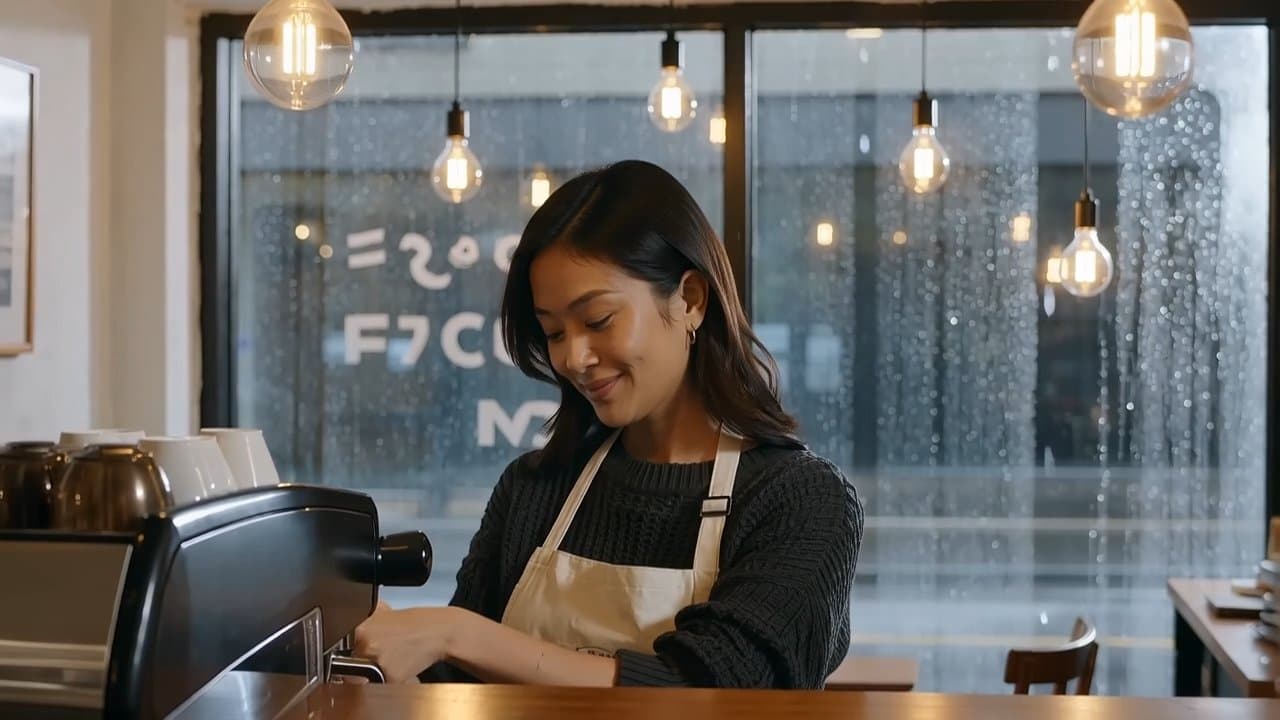
Texto a vídeo · 16:9 · 720P · 7s
HappyHorse 1.0 APIUsar este ejemplo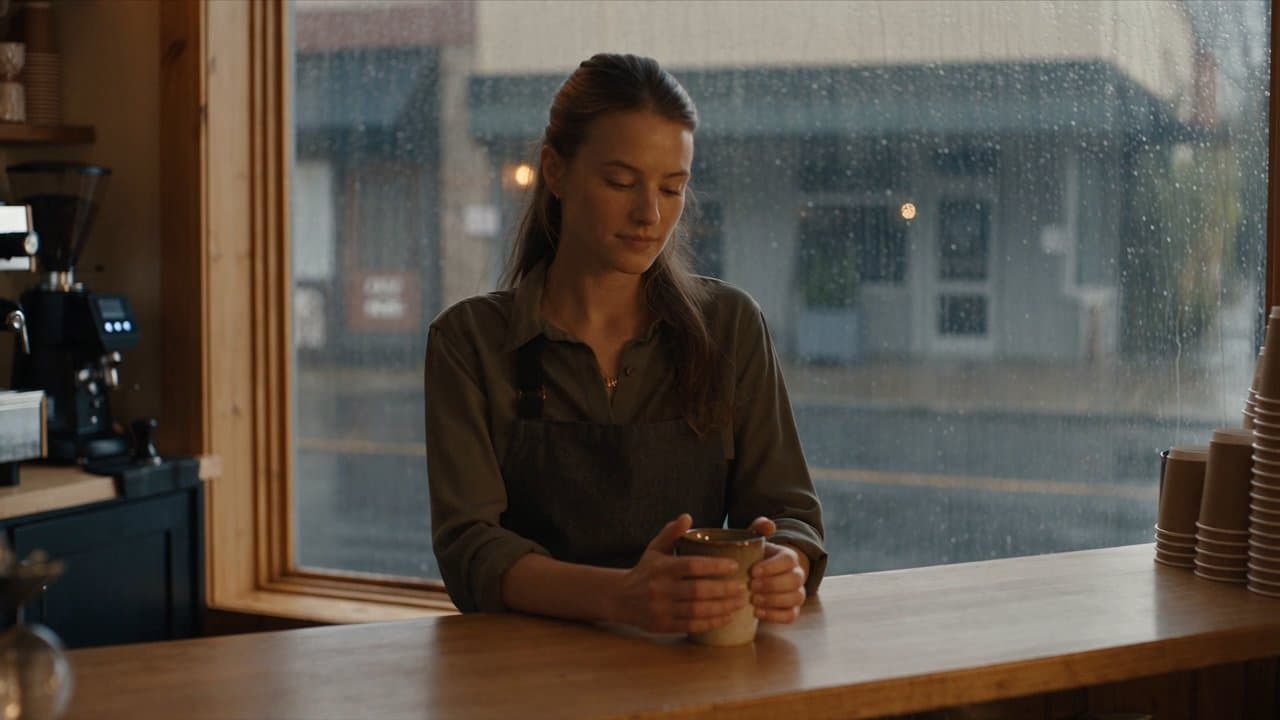
Texto a vídeo · 16:9 · 720p · 7s
SkyReels V4 Fast APIUsar este ejemplo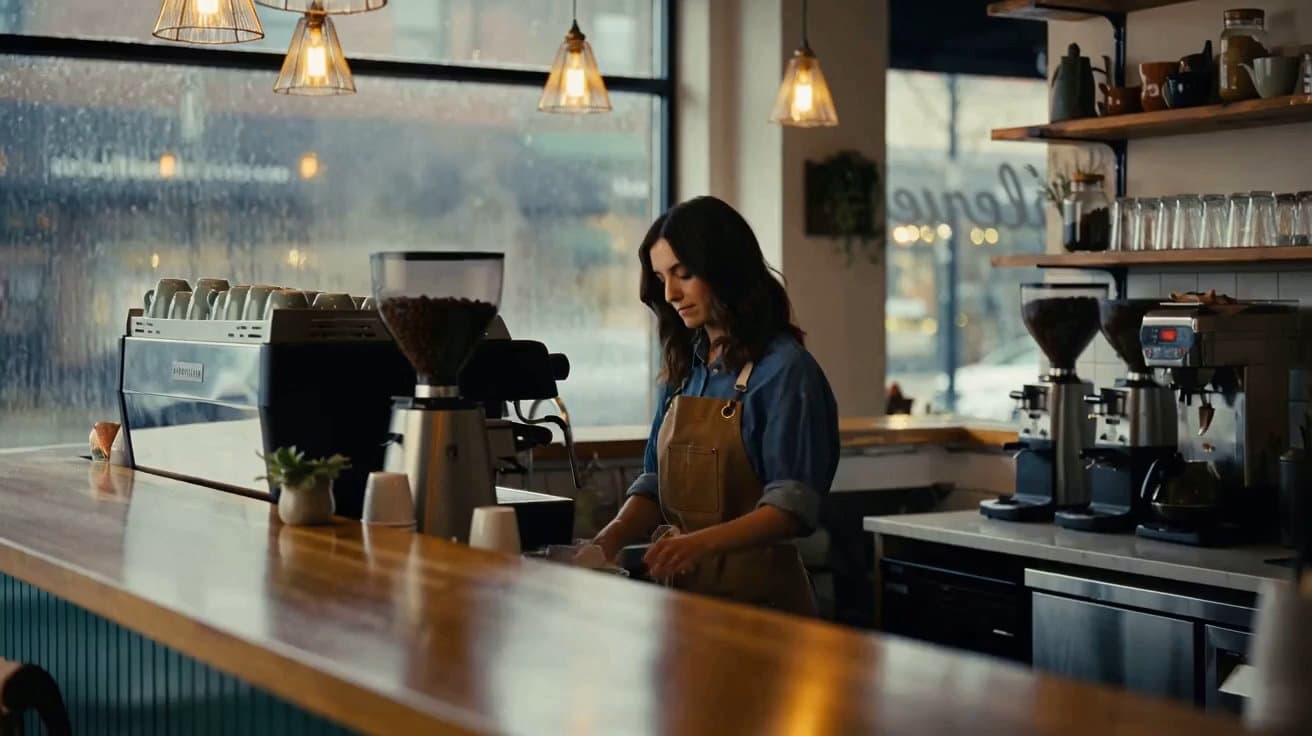
Texto a vídeo · 16:9 · 720p · 7s
SkyReels V4 Std APIUsar este ejemplo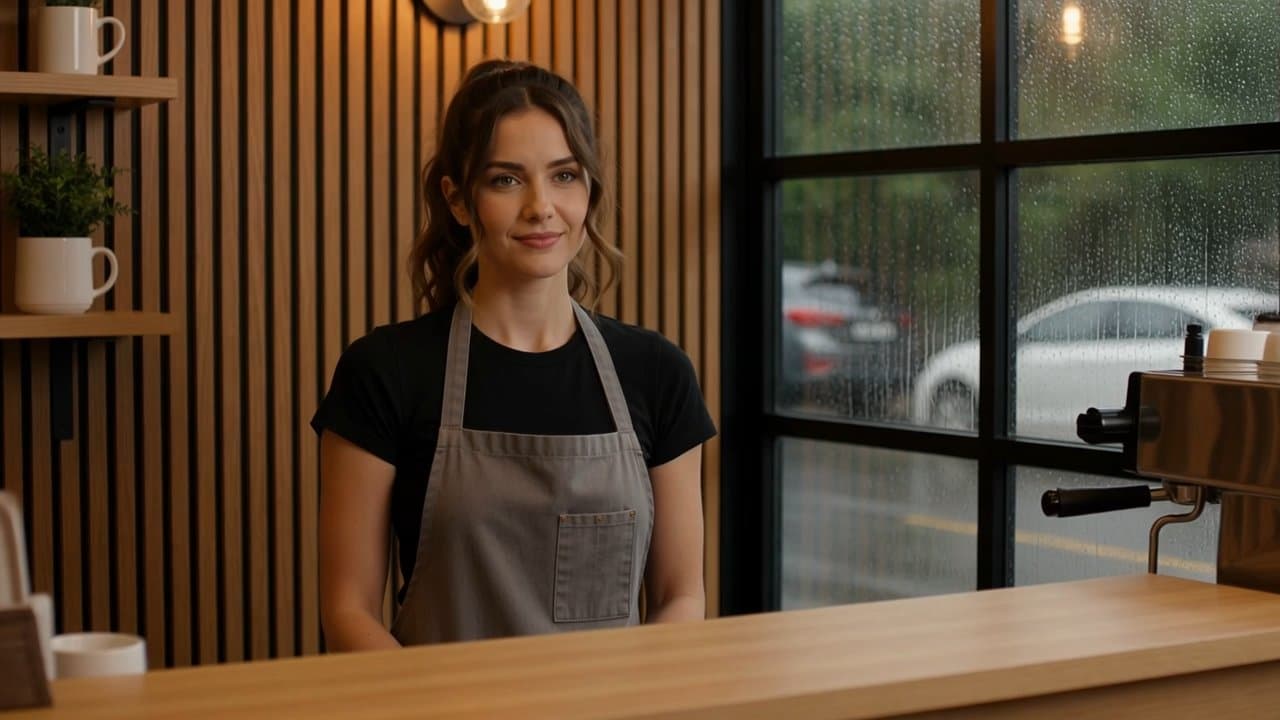
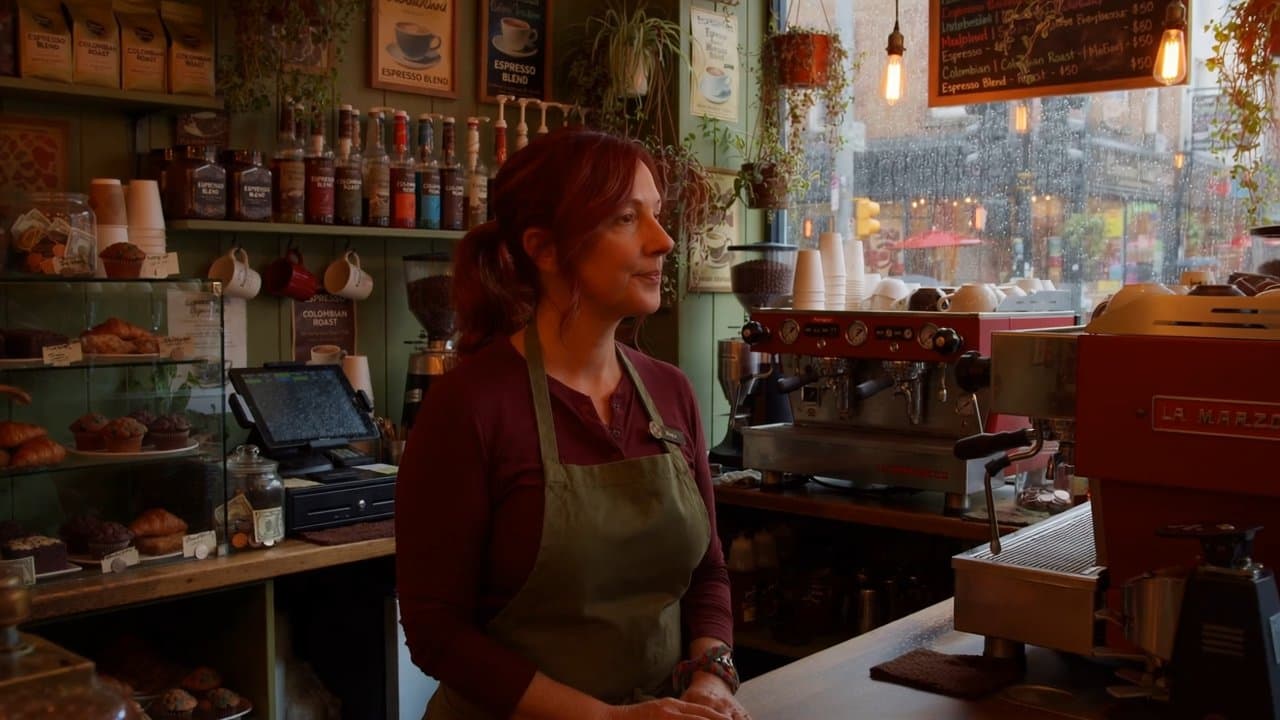
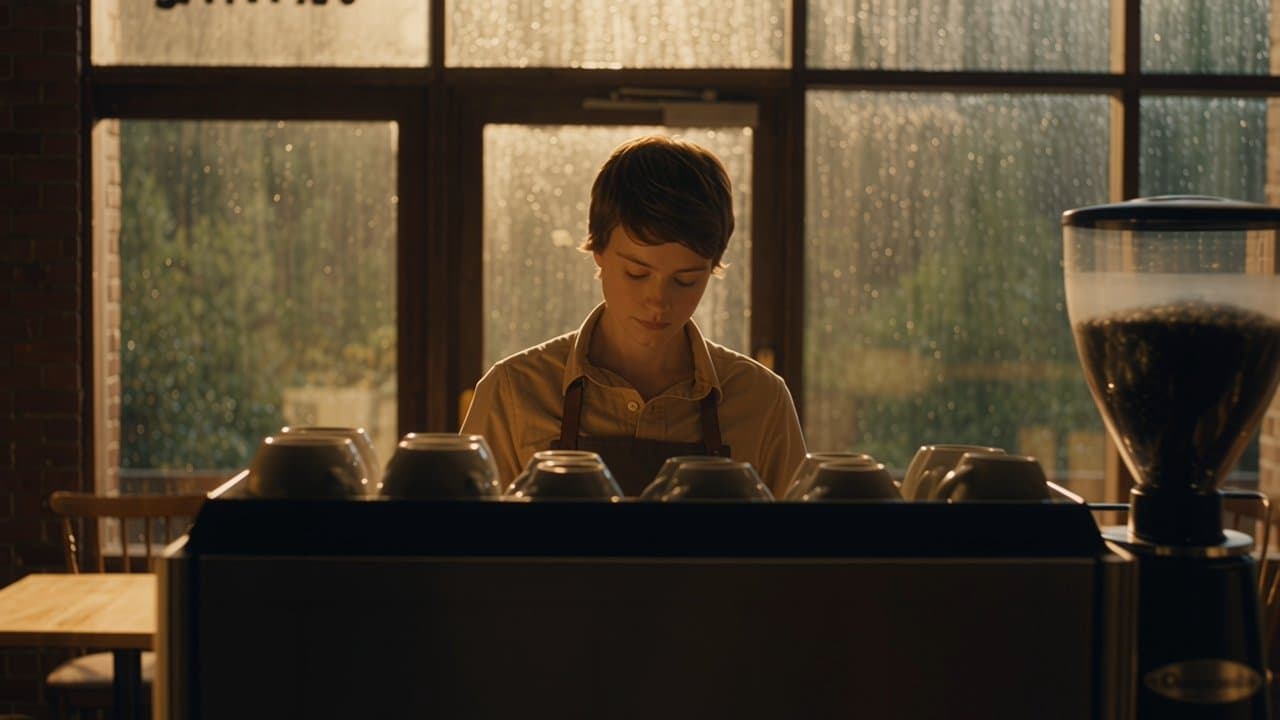
El vídeo con audio nativo genera el diálogo, los efectos y el sonido ambiente junto con la imagen y con los labios sincronizados, así que no hace falta doblaje aparte. Es ideal para diálogos publicitarios, clips narrativos y contenido para redes.
Este caso de uso muestra a alguien tras la barra de una cafetería que dice en voz baja la frase en inglés «Welcome back.» mientras la lluvia golpea la ventana. El prompt preparado pide una sola persona que habla, una frase clara, un movimiento de labios creíble y sonido ambiente de interior, sin subtítulos ni música que tape la voz.
Aquí solo se incluyen modelos con audio nativo, y difieren en calidad de sonido y sincronía labial. Cambia de modelo arriba para compararlos y elige el más natural.
Cada ejemplo es un resultado real del prompt de este caso de uso en ese modelo. Cambia al modelo arriba para usarlo directamente.
| Modelo | Puntos fuertes | Ideal para |
|---|---|---|
| Veo 3.1 Fast API | Audio nativo sincronizado con la imagen, primer y último fotograma | Clips con audio nativo sincronizado |
| HappyHorse 1.0 API | Audio nativo por defecto, imagen a vídeo desde el primer fotograma | Clips con audio nativo |
| Seedance 2.5 API | Hasta 30 segundos, borrador en 480p y versión final en 1080p | Planos largos, del borrador a la versión final |
| SkyReels V4 Fast API | 480p–1080p, 3–15 segundos, fotograma inicial y final y referencias multimodales | Clips multimodales rápidos |
| SkyReels V4 Std API | Primer y último fotograma, y modo Omni con varias imágenes de referencia | Proyectos Omni con varias imágenes de referencia |
| Kling 4.0 API | Cinco modos, 720p / 1080p, 3–30 segundos, siempre con audio estéreo | Clips largos con sonido y varias referencias |
| Muse Video API | Texto e imagen de referencia a vídeo, fijo en unos 10 segundos y 720p, con sonido | Clips de 10 segundos con sonido |
| apimart-zoe API | Audio activado, desactivado o automático, 4–30 segundos o automática, de 480p a 4K | Clips con diálogo hasta 4K, con un borrador en 480p primero |
Cambia de modelo arriba para comparar resultados reales, especificaciones y créditos estimados en este caso de uso.
El prompt de la escena ya define quién habla y los requisitos de audio. Añade debajo una nueva frase, el personaje y el escenario.
Pulsa Ejecutar para generar. Los resultados aparecen a la derecha y puedes recuperarlos en el historial para reutilizar la configuración.
Sí. El prompt de la escena está bloqueado y fija los requisitos de audio, pero puedes añadir debajo una nueva frase y quién la dice. Cuanto más corta sea la frase, más clara y sincronizada saldrá.
El ejemplo usa un diálogo en inglés. Algunos modelos pueden generar voz en chino con resultados variables según el modelo, así que prueba primero con una frase corta antes de generar en lote.
Este caso de uso necesita diálogo nativo sincronizado, así que solo incluye modelos que generan audio. Los modelos sin audio generan vídeo sin sonido.
No. La mayoría de los modelos de vídeo se cobran por segundo y cada uno tiene sus propias especificaciones. El botón Ejecutar muestra los créditos estimados con la configuración actual y se actualiza al cambiar de modelo.
Sí. Cada modelo ofrece una API con los mismos parámetros que la herramienta web. En la página del modelo encontrarás los parámetros de la solicitud y la documentación para generar vídeos con audio en lote.
Puedes contactarnos a través del chat en vivo en la esquina inferior derecha de la página, enviarnos un correo a [email protected] o unirte a nuestra comunidad de Discord. Nuestro equipo te responderá lo antes posible.