所有模型都使用下面同一段提示词生成,方便直接对比对白清晰度、口型同步和环境音。点「使用此示例」即可在上方工具中带入对应模型的参数。
提示词
Create a cinematic video with synchronized natural speech: a barista softly saying Welcome back as rain taps the window. Frame the speaking person clearly, use believable lip motion, room ambience and controlled camera movement. Preserve dialogue meaning and avoid subtitles. This prompt is for routes with verified native voice or audio generation only; otherwise disable this scene/model pairing. Native synchronized spoken dialogue required. Exact English dialogue: “Welcome back.” One speaker, one intelligible line, no subtitles, no music masking speech.
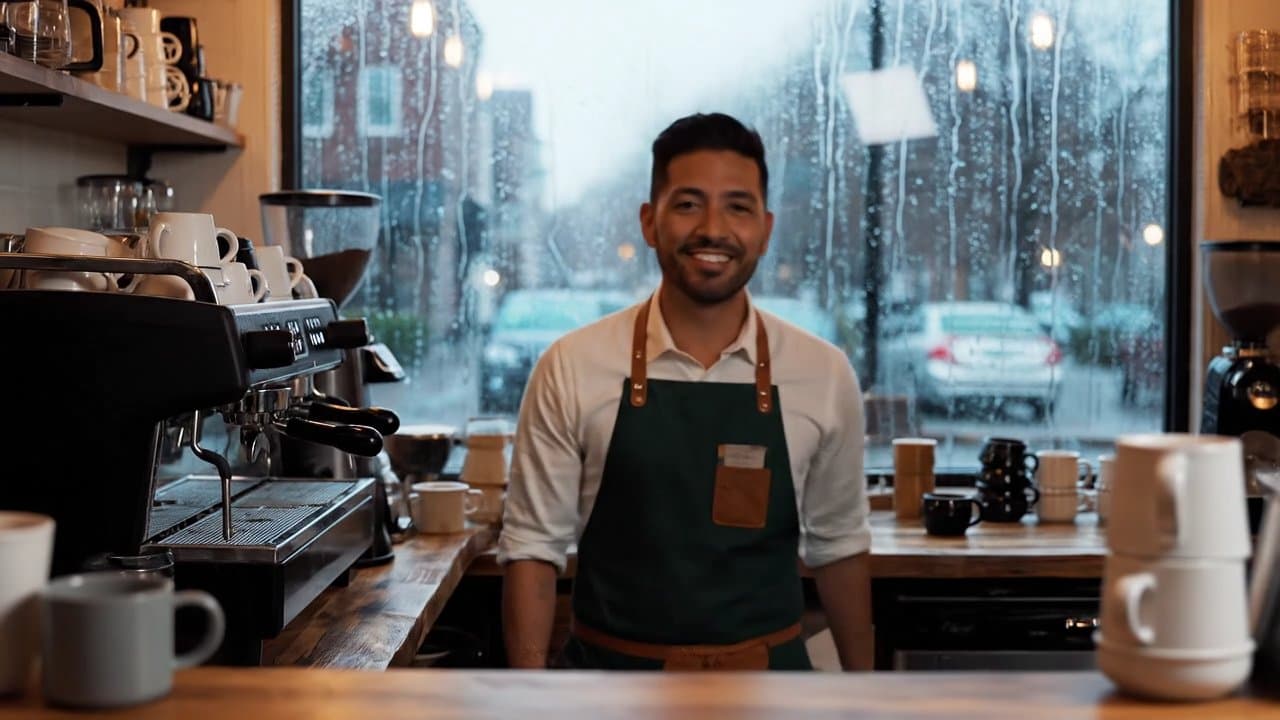
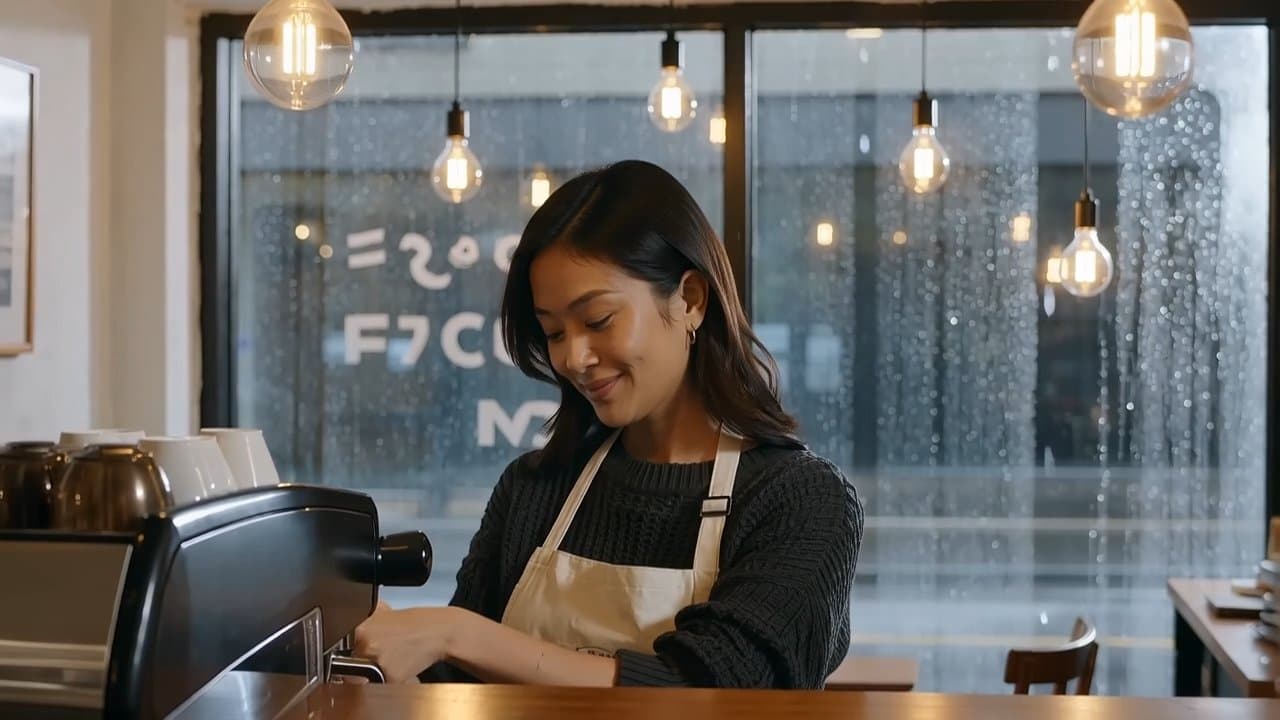
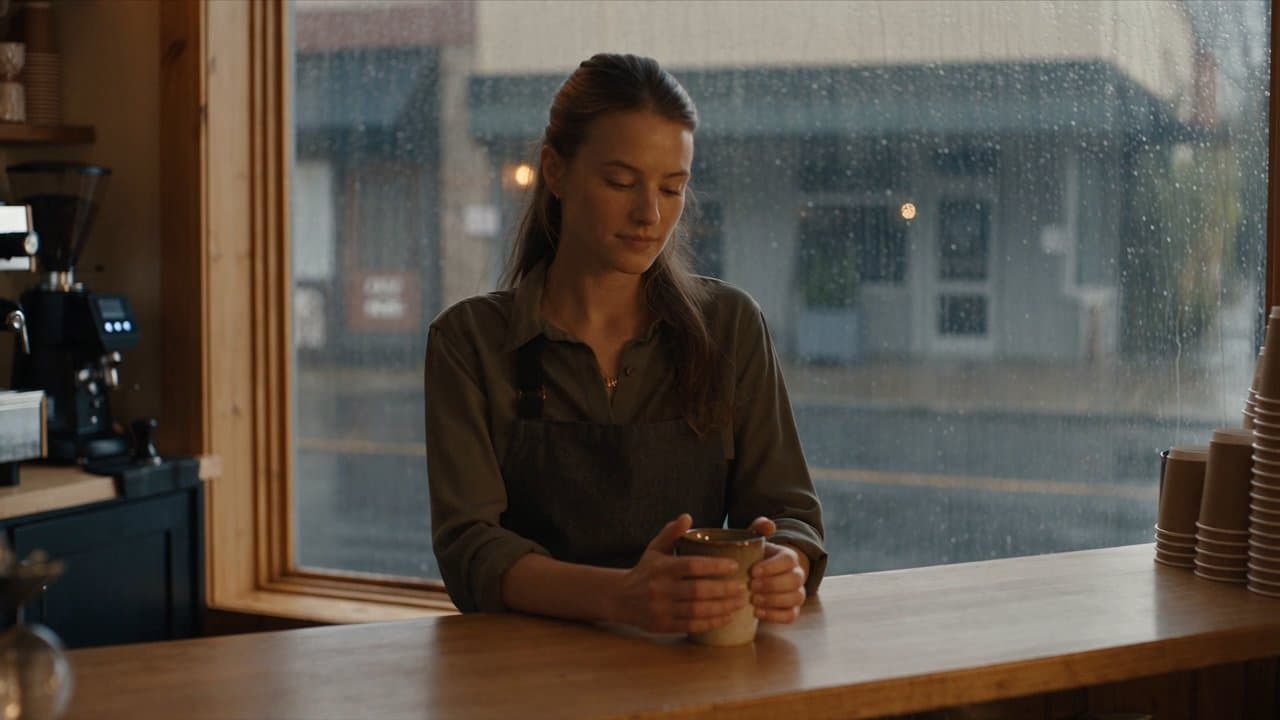
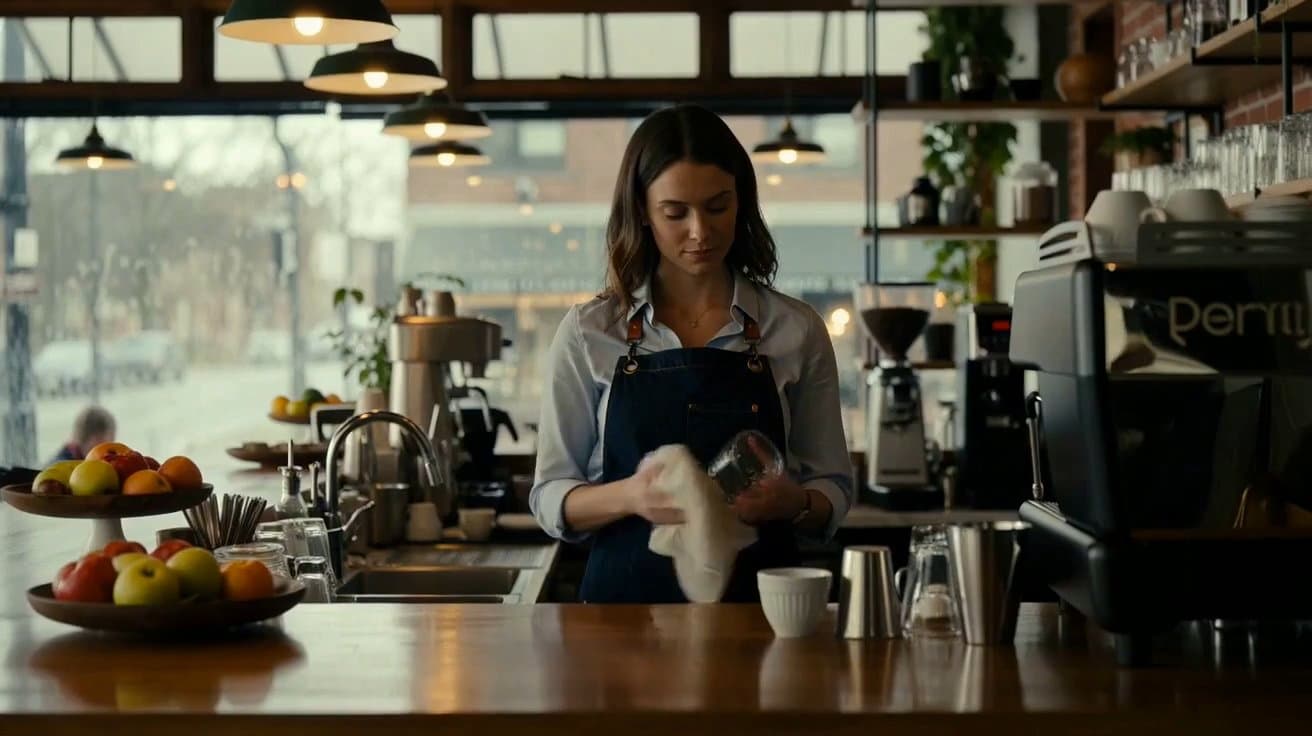
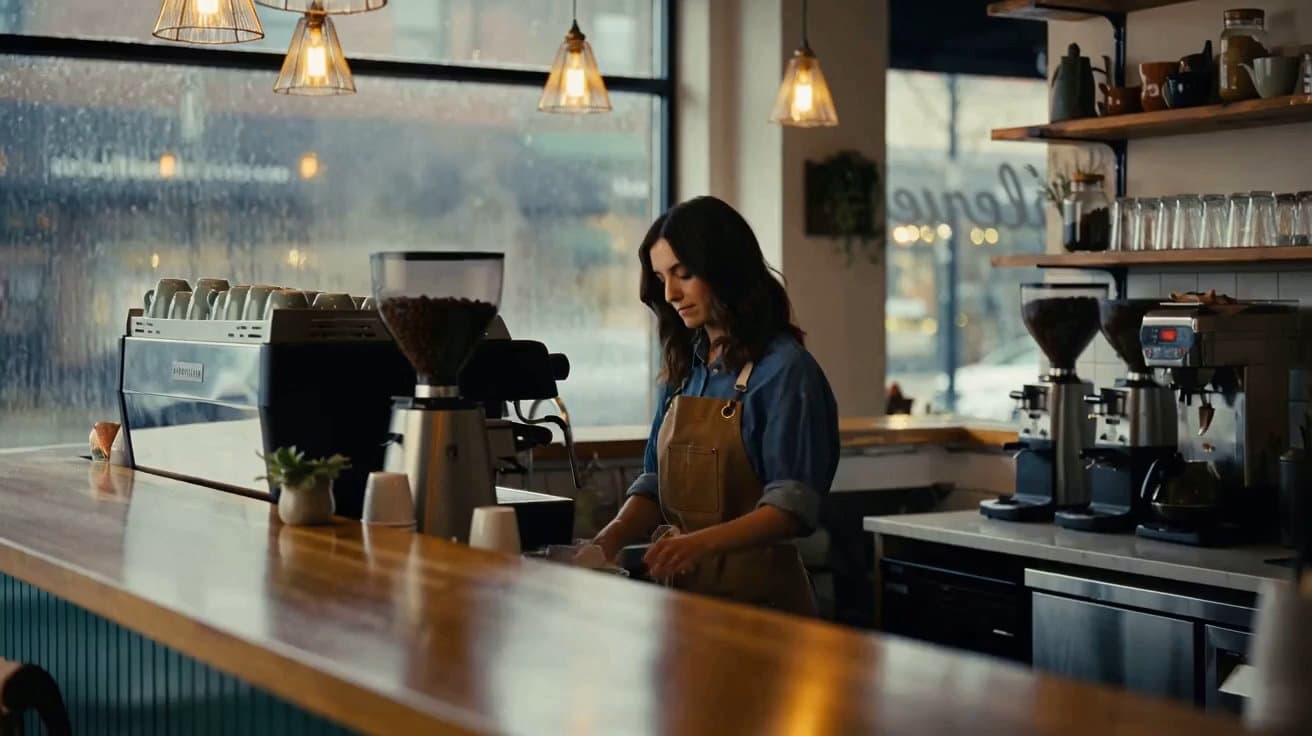
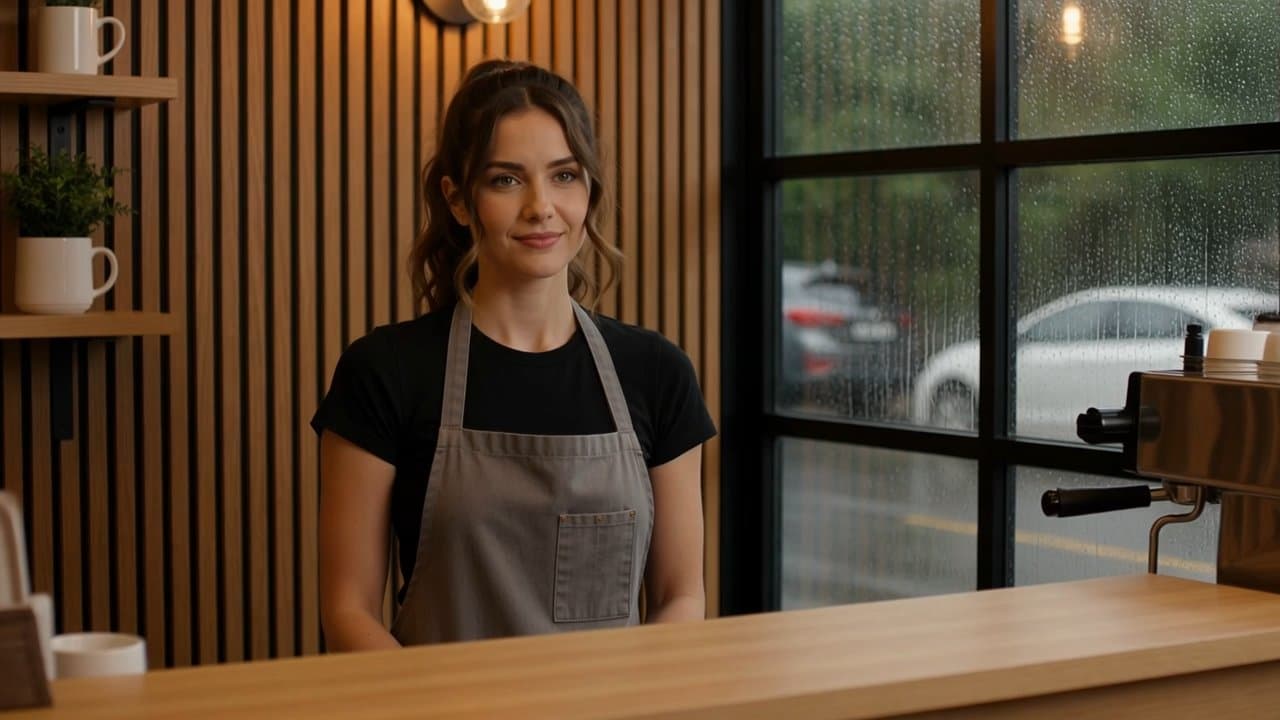
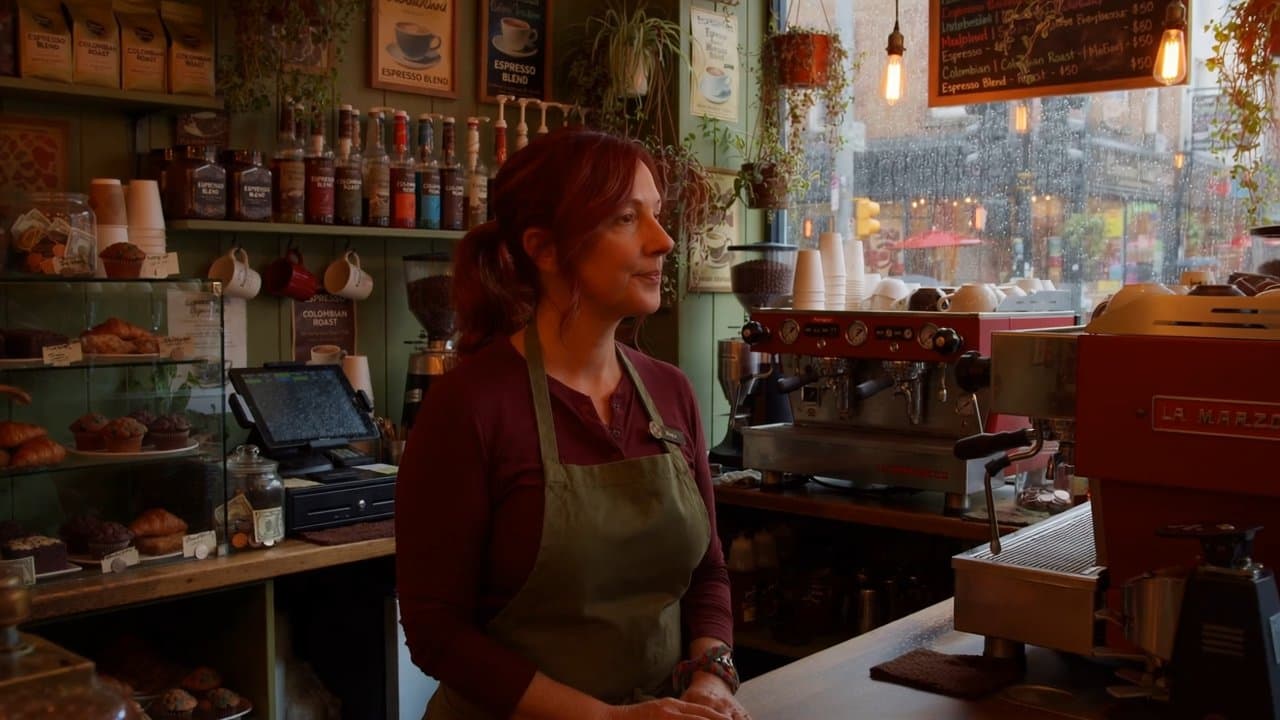
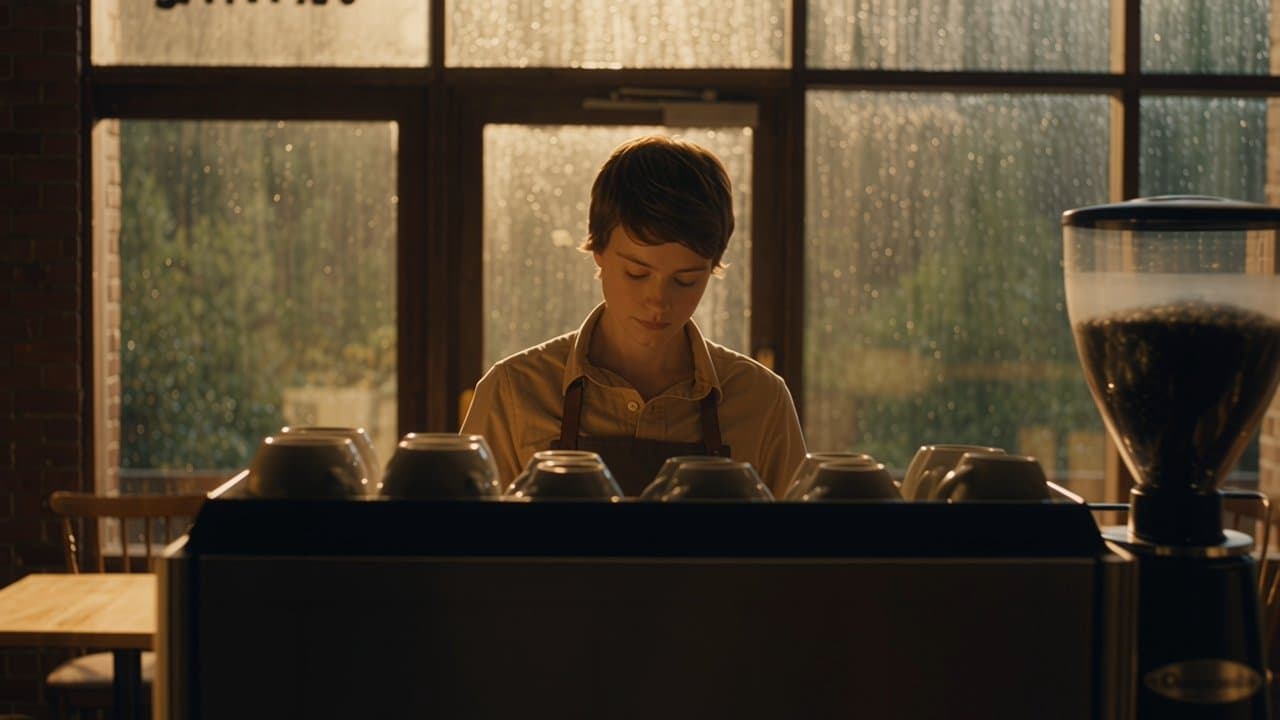
原生音频视频在生成画面的同时生成对白、音效和环境声,口型与声音同步,省去后期配音,适合广告对白、剧情短片和社媒内容。
这个场景以一位咖啡师为例:窗外下着雨,咖啡师轻声说出英文对白「Welcome back.」。预设要求只有一位说话者、一句清晰的台词,口型可信、有室内环境声,不加字幕、不用音乐盖过人声。
这个场景只放了支持原生音频的模型,它们在声音质量和口型同步上表现不同。在上方切换模型对比,再选出最自然的一款。
以下示例都是本场景预设在对应模型上的真实生成效果,在上方切换到该模型即可直接使用。
| 模型 | 擅长 | 适合 |
|---|---|---|
| Veo 3.1 Fast API | 原生音频与画面同步生成,支持首尾帧 | 原生音画同步的短片 |
| HappyHorse 1.0 API | 默认生成原生音频,支持首帧图生视频 | 带原生音频的短片 |
| Seedance 2.5 API | 最长 30 秒,可先出 480p 样片再转 1080p 正式片 | 长镜头与样片转正式片 |
| SkyReels V4 Fast API | 480p–1080p、3–15 秒,支持首尾帧与多模态参考 | 快速的多模态短片 |
| SkyReels V4 Std API | 支持首尾帧与多张参考图的 Omni 模式 | 多参考图的 Omni 创作 |
| Kling 4.0 API | 五种模式,720p / 1080p、3–30 秒,始终带立体声 | 长镜头与多素材参考的有声短片 |
| Muse Video API | 文生与参考图生视频,固定约 10 秒 · 720p,自带声音 | 带声音的 10 秒短片 |
| apimart-zoe API | 音频可选开 / 关 / 自动,4–30 秒或自动时长,480p 到 4K | 先出 480p 样片、最高 4K 的对白短片 |
在上方切换模型,对比它们在本场景的真实效果、规格与预计积分。
场景提示词已写好说话者与音频要求,可以在下方补充新的台词、人物和场景。
点击运行开始生成,结果显示在右侧,也可以在历史任务中找回并复用参数。
可以。场景提示词已锁定音频要求,你可以在下方补充新的台词和说话者,台词越短越容易清晰、同步。
示例是英文对白。部分模型可以生成中文语音,效果因模型而异,建议先短句测试再批量生成。
本场景要求原生同步对白,只放了支持音频生成的模型;不支持音频的模型生成的是无声视频。
不一样。视频大多按秒计费,各模型规格不同,运行按钮会显示当前参数下的预计积分,切换模型后自动更新。
可以。每个模型都提供与网页相同参数的 API,在模型详情页可以查看请求参数与文档,适合批量制作有声视频。
你可以通过页面右下角的在线客服、发送邮件至 [email protected],或在 Discord 社区中联系我们。我们的团队会尽快回复你的问题。
